0.2 一张图看懂四层
一条请求的时间、字节与状态账本
面试里最容易被问的开场题:「LLM 推理加速你了解哪些方法?」 不要一上来就报菜名,先给框架。
术语先立住:LLM(Large Language Model,大语言模型) 指参数量在十亿级以上的 Transformer 类自回归语言模型;本手册讨论的「推理(Inference)」特指训练完成后的前向计算与在线服务,不含训练与微调。
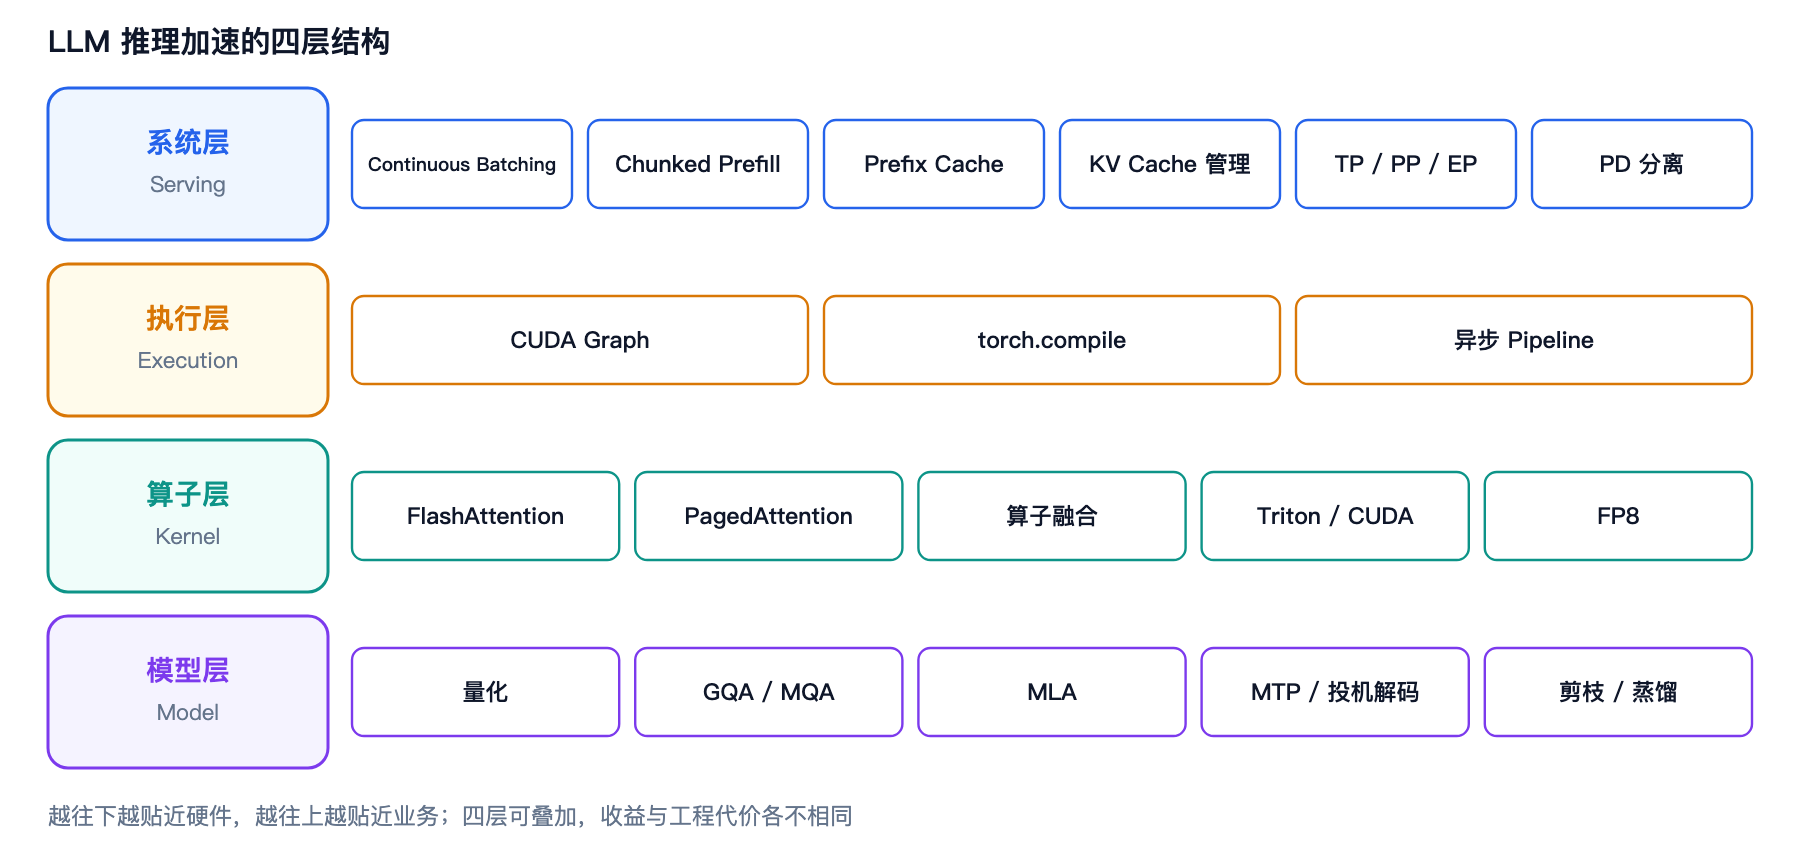 图 0-1 · LLM 推理加速的四层结构:越往下越贴近硬件,越往上越贴近业务
为什么这样分层? 因为四层的优化对象不同:模型层改「要算什么」,算子层改「单个算子怎么算」,执行层改「怎么把算子交给 GPU」,系统层改「多个请求怎么排队共享资源」。四层互不冲突、可以叠加,但收益与工程代价差异巨大。