6.7 减少 KV Cache 的六类手段(面试必背)
KV 块分配、分页寻址与前缀复用
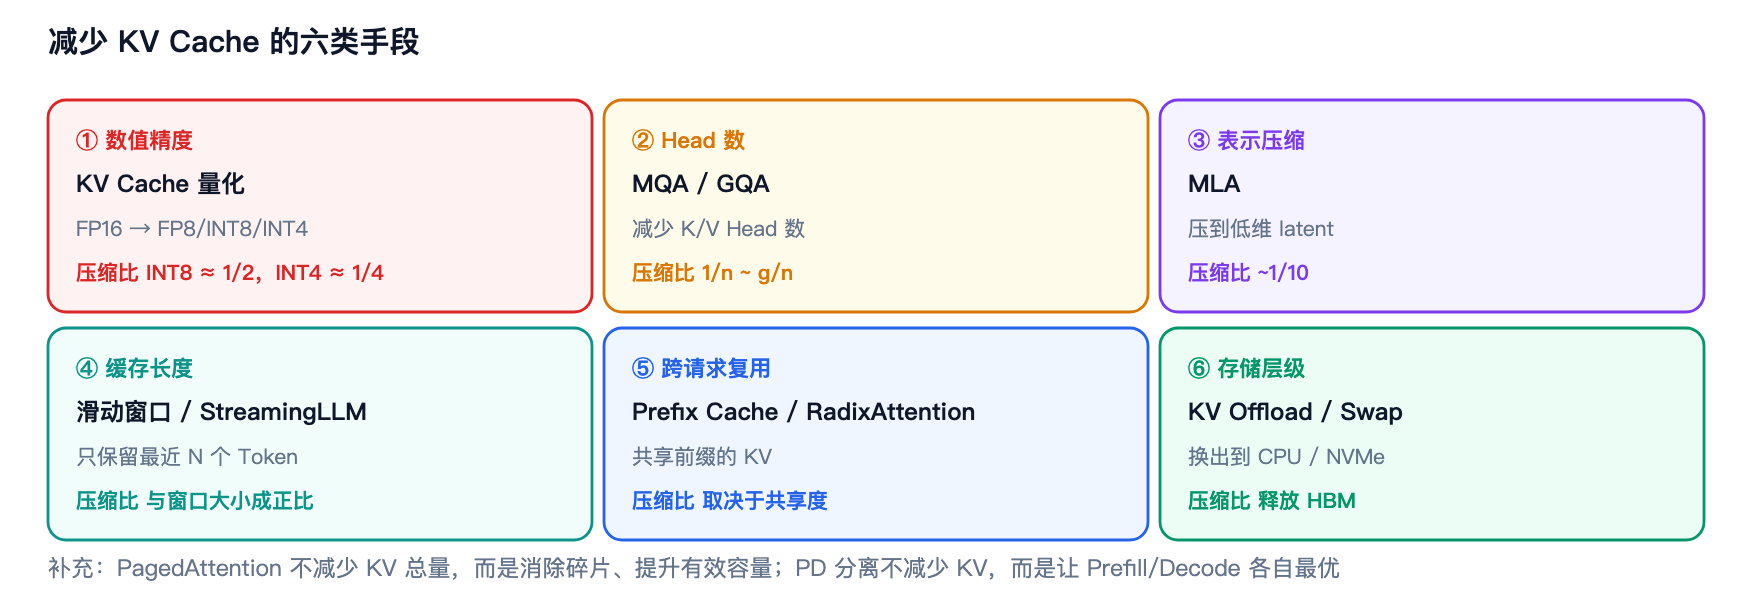 图 6-1 · 六类手段、机制与压缩比一览
| 类别 | 手段 | 机制 | 压缩比 | 代价 |
|---|---|---|---|---|
| ① 数值精度 | KV Cache 量化 | FP16/BF16 → FP8 / INT8 / INT4 | INT8 ≈ 1/2,INT4 ≈ 1/4 | 精度损失、需融合反量化 |
| ② Head 数 | MQA / GQA | 减少 K/V Head 数 | 1/n ~ g/n | 轻微质量损失 |
| ③ 表示压缩 | MLA | KV 压到低维 latent | 依模型配置计算 | 需模型原生支持、专用投影/Attention 路径 |
| ④ 缓存长度 | 滑动窗口 / StreamingLLM | 只保留最近 N 个 Token | 与窗口大小成正比 | 丢失长程信息 |
| ⑤ 跨请求复用 | Prefix Cache / RadixAttention | 共享前缀的 KV | 取决于共享度 | 哈希/索引开销、Block 粒度损失 |
| ⑥ 存储层级 | KV Offload / Swap | 换出到 CPU/NVMe | 释放 HBM | PCIe/SSD 带宽瓶颈、延迟上升 |
补充:还有 PagedAttention(不减少 KV 总量,而是消除碎片、提升有效容量)和 PD 分离(不减少 KV,而是让 Prefill/Decode 各自最优)。
前沿模型还会改变“每 Token 每层都缓存一份 KV”的前提:DeepSeek-V4 的 CSA/HCA 压缩历史条目,V4.1 的 CSA2 跨层共享、FP4 主 KV 和 SWA 短期状态分别影响条目数、字节数与缓存层级。具体账本见第 23 章。