0.4 加速的本质:三个瓶颈
一条请求的时间、字节与状态账本
所有推理加速技术,最终都在解决下面三个瓶颈之一。面试时先把问题定位到瓶颈,再谈技术,会显得非常有条理。
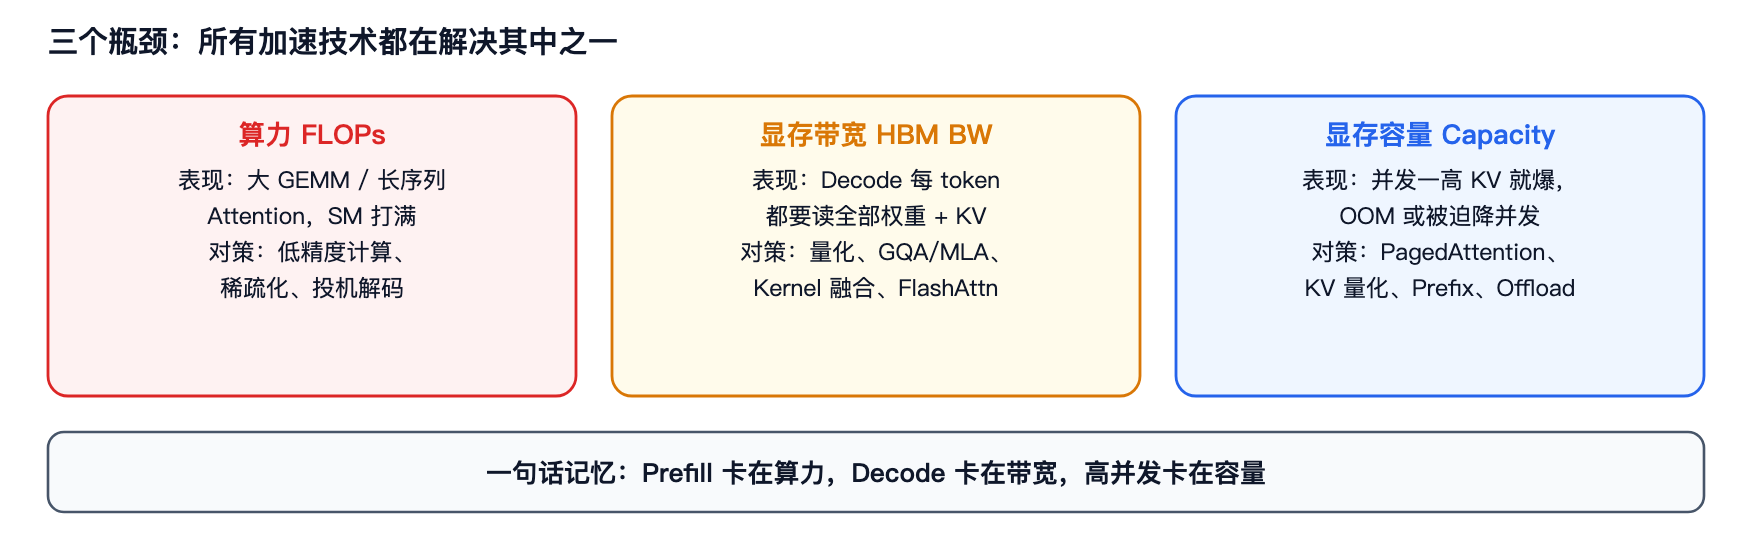 图 0-2 · 三个瓶颈与各自的典型对策
| 瓶颈 | 表现 | 典型对策 |
|---|---|---|
| 算力(FLOPs) | 大 GEMM、长序列 Attention,SM 打满 | 低精度计算(FP8/INT8)、稀疏化、投机解码 |
| 显存带宽(HBM BW) | Decode 阶段每 token 都要读全部权重 + KV | 量化、GQA/MLA、Kernel 融合、FlashAttention |
| 显存容量 | 并发一高 KV Cache 就爆,OOM 或降并发 | PagedAttention、KV 量化、Prefix Cache、Offload、PD 分离 |
术语解释:
- FLOPs(Floating-point Operations,浮点运算次数):衡量计算量的单位,注意与 FLOP/s(每秒浮点运算次数,衡量算力)区分。
- GEMM(General Matrix Multiply,通用矩阵乘法):
C = A × B形式的稠密矩阵乘,是 Transformer 里 Linear 层的主体,也是 GPU 上最擅长、最成熟的算子形态。 - SM(Streaming Multiprocessor,流多处理器):GPU 的基本计算单元,一块 GPU 由几十到上百个 SM 组成;「SM 打满」指所有计算单元都在忙。
- OOM(Out Of Memory,显存不足):显存分配失败导致进程报错退出。
- Offload(卸载):把暂时不用的数据从显存搬到 CPU 内存或 NVMe,需要时再搬回。
一句话记忆:Prefill 卡在算力,Decode 卡在带宽,高并发卡在容量。