6.4 Prefix Cache / RadixAttention
KV 块分配、分页寻址与前缀复用
速查:Prefix Cache 把已经算过的 KV Cache 按前缀哈希存起来,相同前缀的后续请求直接复用,避免重复 Prefill。SGLang 的 RadixAttention 用基数树(Radix Tree,一种按公共前缀压缩存储的树结构) 组织,支持更灵活的前缀匹配与 LRU 淘汰。
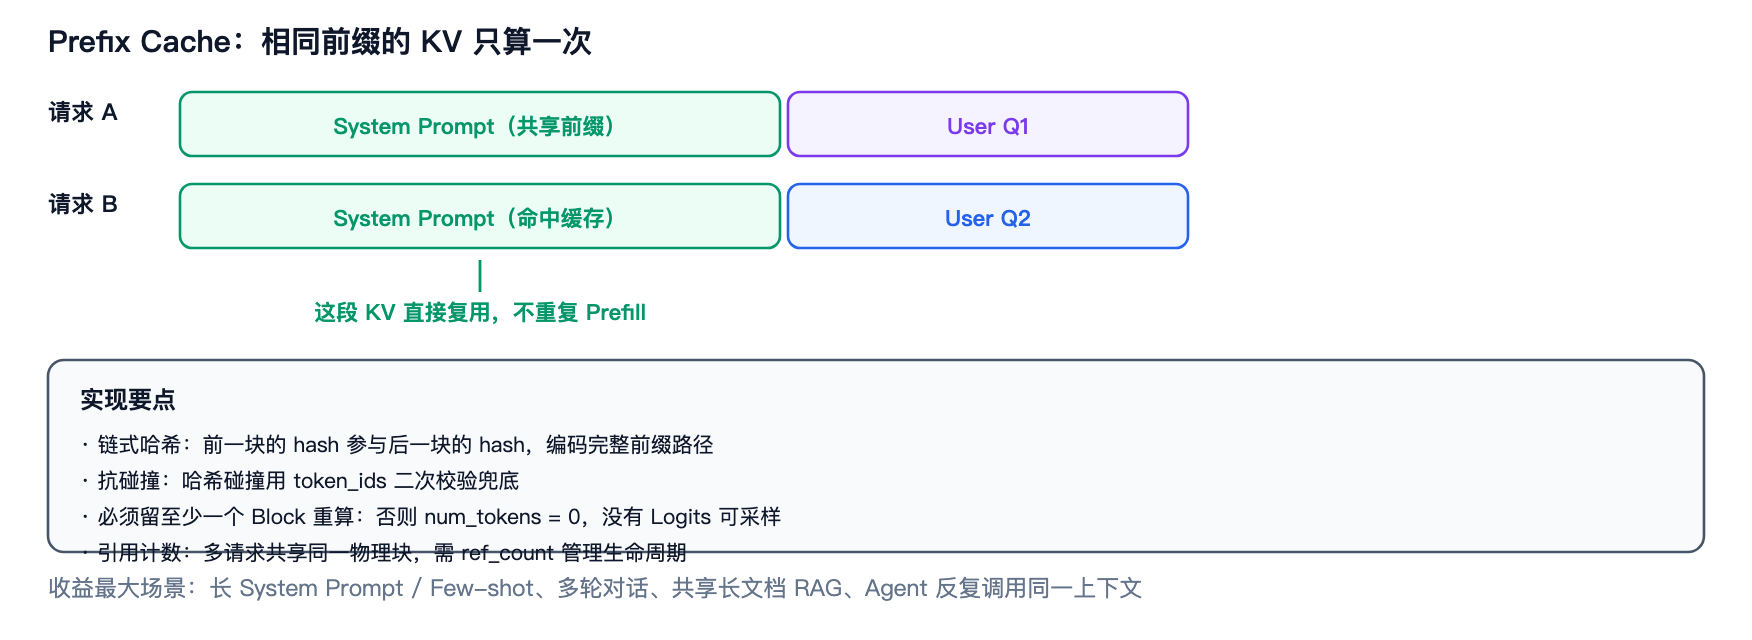 图 5-3 · 共享前缀的 KV 只算一次,后续请求直接命中复用
术语解释:
- Prefix Cache(前缀缓存):缓存已计算的前缀 KV,供后续同前缀请求复用。
- RadixAttention(基数树注意力):SGLang 提出的方案,用基数树管理前缀 KV,支持树上前缀查找和节点淘汰,实际可复用长度仍受 KV 分配粒度与实现约束。
- LRU(Least Recently Used,最近最少使用):一种缓存淘汰策略,优先淘汰最久未访问的条目。
- 链式哈希(Chained Hash):后一块的哈希值由「前一块哈希 + 本块 Token」共同决定,使哈希编码完整前缀路径。
请求 A: [System Prompt][User Q1]
请求 B: [System Prompt][User Q2]
        └─ 相同前缀,KV 只算一次 ─┘

实现:以 Block 为单位做链式哈希
     hash → physical_block_id 映射表
     命中则复用,未命中则新算
码 5-3 · Prefix Cache 的链式哈希与碰撞兜底
import hashlib

def compute_hash(token_ids, prefix_hash=0):
    """链式哈希:把「前一块的哈希」当种子,使哈希值编码完整前缀路径。
    示意实现;生产中跨租户复用还需把模型与租户隔离等上下文编码进 key,并选择足够抗碰撞的哈希。"""
    payload = prefix_hash.to_bytes(8, "little") + b"".join(int(t).to_bytes(4, "little") for t in token_ids)
    return int.from_bytes(hashlib.blake2b(payload, digest_size=8).digest(), "big")

h, hits = 0, 0
for blk in chunked(token_ids, block_size):
    h = compute_hash(blk, h)                     # ← 依赖前一块:顺序敏感
    block = hash_to_block_id.get(h)
    if block is None:
        break                                    # 未命中:从这里开始全部重算
    if block.token_ids != blk:
        break                                    # 哈希碰撞 → 用 token_ids 二次校验兜住
    hits += 1

# 完全命中时是否重算最后一个 token,取决于引擎能否取得采样所需 logits。
链式哈希编码块顺序;示例用 token_ids 二次校验防碰撞。真实系统还需校验模型、LoRA、位置、租户隔离等上下文;完全命中时如何获得 logits 要看引擎设计。
关键设计点:
- 哈希必须编码完整路径:链式哈希保证前缀顺序敏感。
- 抗碰撞:哈希碰撞要用 token_ids 二次校验兜底。
- 完整命中后的 logits:按引擎设计选择缓存 logits、重算末尾 token 或其他机制;不能把重算一块当普遍要求。
- 引用计数:多请求共享同一物理块,需要 ref_count 管理生命周期。
追问:Prefix Cache 什么时候收益最大?
① 长 System Prompt / Few-shot 示例;② 多轮对话(历史上下文复用);③ 共享长文档的 RAG(Retrieval-Augmented Generation,检索增强生成,先检索再生成)场景;④ Agent 场景反复调用同一上下文。前缀越长、共享度越高,收益越大。