6.3 PagedAttention
KV 块分配、分页寻址与前缀复用
速查:PagedAttention 借鉴操作系统虚拟内存分页,把 KV Cache 切成固定大小的 Block(块),用 Block Table(块表) 做逻辑到物理的映射,减少外部碎片并支持前缀共享;尾块浪费、元数据和预留仍存在,具体浪费率依请求长度与块大小而变。
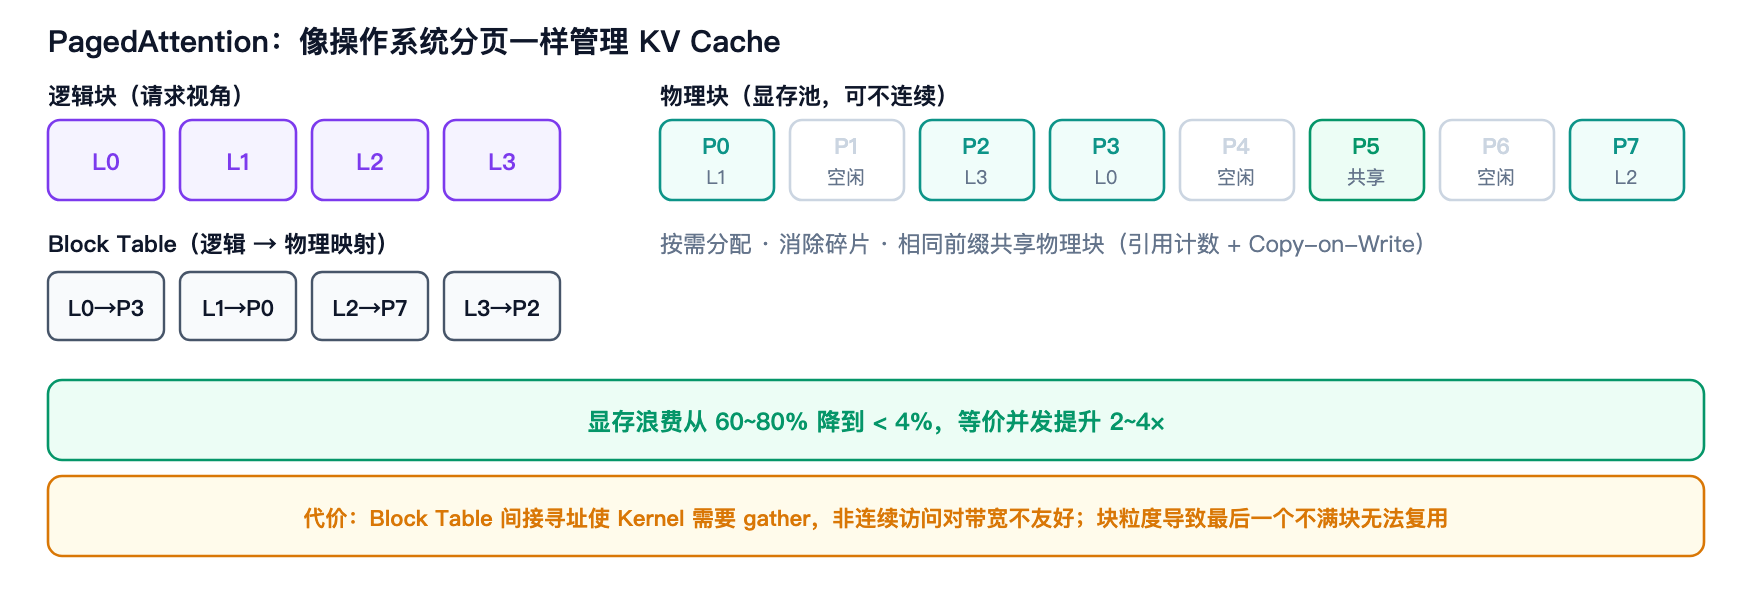 图 3-2 · 逻辑块经 Block Table 映射到不连续的物理块,支持共享与按需分配
术语解释:
- PagedAttention(分页注意力):vLLM 提出的 KV Cache 管理方案,用分页思想解决显存碎片。
- Block(块)/ Block Table(块表):Block 是固定 Token 数的 KV 存储单元(如 16 个 Token);Block Table 记录「逻辑块号 → 物理块号」的映射,物理块可以不连续。
- 显存碎片(Memory Fragmentation):内部碎片指分配了但没用满的部分;外部碎片指空闲空间分散、无法满足大块连续分配。
- Copy-on-Write(写时复制):多个请求共享同一物理块,只有当某一方要修改时才复制出私有副本,用于 Beam Search、并行采样等场景。
- 引用计数(Reference Count):记录一个物理块被多少请求共享,归零才回收。
传统 KV Cache:每个请求预留 max_seq_len 连续显存
  → 内部碎片(实际长度 < 预留长度)
  → 外部碎片(不同长度请求难拼合)

PagedAttention:
  Block = 固定 token 数(如 16)的 KV 存储单元
  Block Table:逻辑块号 → 物理块号(可以不连续!)
  → 按需分配,用多少占多少
  → 相同前缀可共享物理块(引用计数 + Copy-on-Write)
收益: 码 3-2 · 逻辑块 → 物理槽位的映射
def slot_mapping(block_table, seq_len, block_size):
    """把逻辑位置翻译成物理 KV 槽位。block_table[k] 是第 k 个逻辑块的物理块号。"""
    slots = []
    for pos in range(seq_len):
        phys_block = block_table[pos // block_size]        # 间接寻址:逻辑 → 物理
        slots.append(phys_block * block_size + pos % block_size)
    return slots

# 例:block_size=4,block_table=[7, 2, 9]
# seq_len=10 → slots = [28,29,30,31, 8,9,10,11, 36,37]
#              └─ 逻辑连续 ─┘  └─ 物理跳号 ─┘
block_table里的物理块号不连续(上例从 7 跳到 2 再跳到 9),所以 kernel 只能拿着slots做 gather。这就是 PagedAttention 的性能代价:用非连续访存换掉了显存碎片和按最大长度预留的浪费。
- 显存浪费 <4%(论文数据),等价于并发提升 2–4×。
- 支持 Prefix Sharing(前缀共享):多个请求共享同一前缀的物理块(如 system prompt、few-shot 示例)。
追问:PagedAttention 的代价是什么?
① Block Table 的间接寻址让 Kernel 复杂化(需要 gather(按索引收集数据)),非连续访问对带宽不友好;② 块粒度导致「最后一个不满块」无法复用(prefix cache 的固有代价);③ 需要专门的 Paged Attention Kernel 来高效读取。