7.5 推理链路:Tokenize → Detokenize
自回归生成、KV 生命周期、性能指标与 Roofline
速查:Tokenizer → Scheduler 分配资源 → Prefill 建立 KV Cache → Decode 逐 Token 生成 → Detokenize 返回。
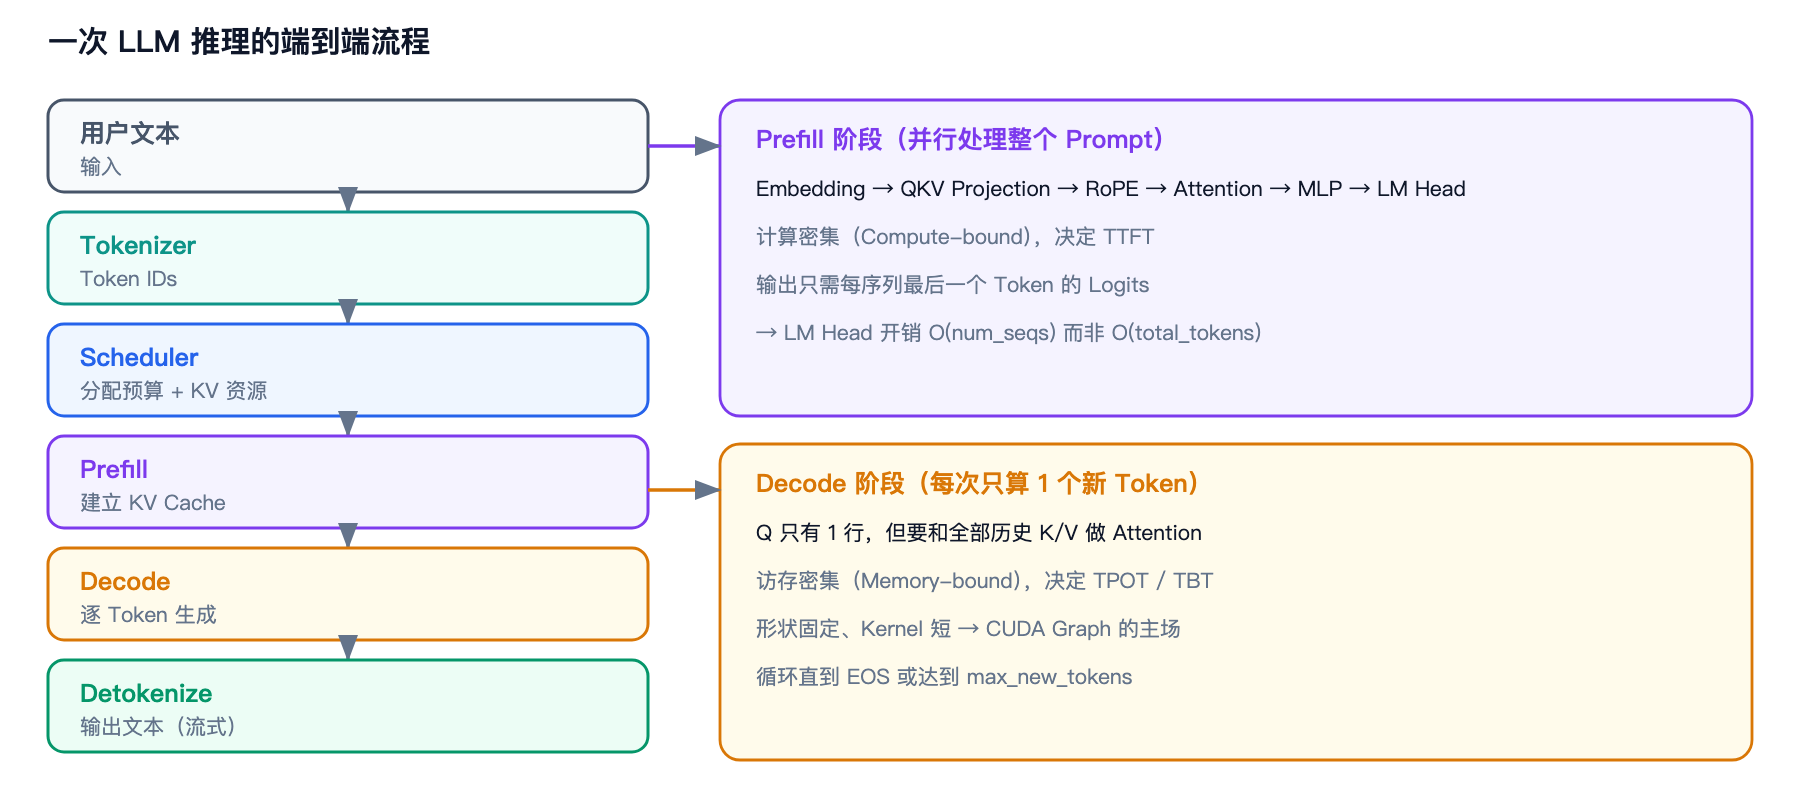 图 1-1 · 端到端流程,以及 Prefill / Decode 两个阶段的内部构成
用户输入文本
    │
    ▼
Tokenizer ──► Token IDs
    │
    ▼
Scheduler ──► 分配计算预算 + KV Cache 资源
    │
    ▼
┌──────────────────────── Prefill ────────────────────────┐
│ Embedding → QKV Projection → RoPE → Attention → MLP →   │
│ LM Head → Logits                                        │
│ (并行处理整个 Prompt,建立 KV Cache)                    │
└─────────────────────────────────────────────────────────┘
    │
    ▼
┌──────────────────────── Decode ─────────────────────────┐
│ 每次只算 1 个新 Token,复用历史 KV Cache,循环直到         │
│ EOS 或达到 max_new_tokens                               │
└─────────────────────────────────────────────────────────┘
    │
    ▼
Detokenize ──► 返回文本(通常流式)
术语解释:
- Scheduler(调度器):决定每一轮把哪些请求放进 Batch、分配多少 Token 预算和 KV Cache 空间的组件,是推理框架的核心大脑。
- Embedding(嵌入层):把 Token ID 映射成稠密向量的查表层。
- QKV Projection(QKV 投影):用三个(或融合为一个)线性层,把隐藏状态投影成 Attention 需要的 Query / Key / Value 三个矩阵。
- RoPE(Rotary Position Embedding,旋转位置编码):通过旋转复数向量把位置信息注入 Q/K 的编码方式,是当前主流 LLM 的位置编码方案。
- Attention(注意力机制):
softmax(QKᵀ/√d)V的计算,让每个 Token 按相关性聚合其他 Token 的信息。 - MLP(Multi-Layer Perceptron,多层感知机)/ FFN(Feed-Forward Network,前馈网络):Transformer 块里 Attention 之后的两层全连接网络,通常含 SiLU 激活与门控,是参数量的主要来源。
- LM Head(语言模型输出头):把最后一层隐藏状态投影到词表维度的线性层,输出 Logits。
- Logits(未归一化分数):模型对词表中每个 Token 的原始打分,经 softmax 后成为概率分布,供 Sampling(采样) 使用。
- EOS(End Of Sequence,序列结束符):模型输出该 Token 表示生成结束。
- Detokenize(反分词):把生成的 Token ID 序列还原为可读文本。