1.2 GPU 基础补课:Tensor Core / GEMM / 显存层次
SM、Warp、Block、存储层次与占用率
面试推理岗,必须能说清 GPU 的存储层次和 GEMM 优化思路。
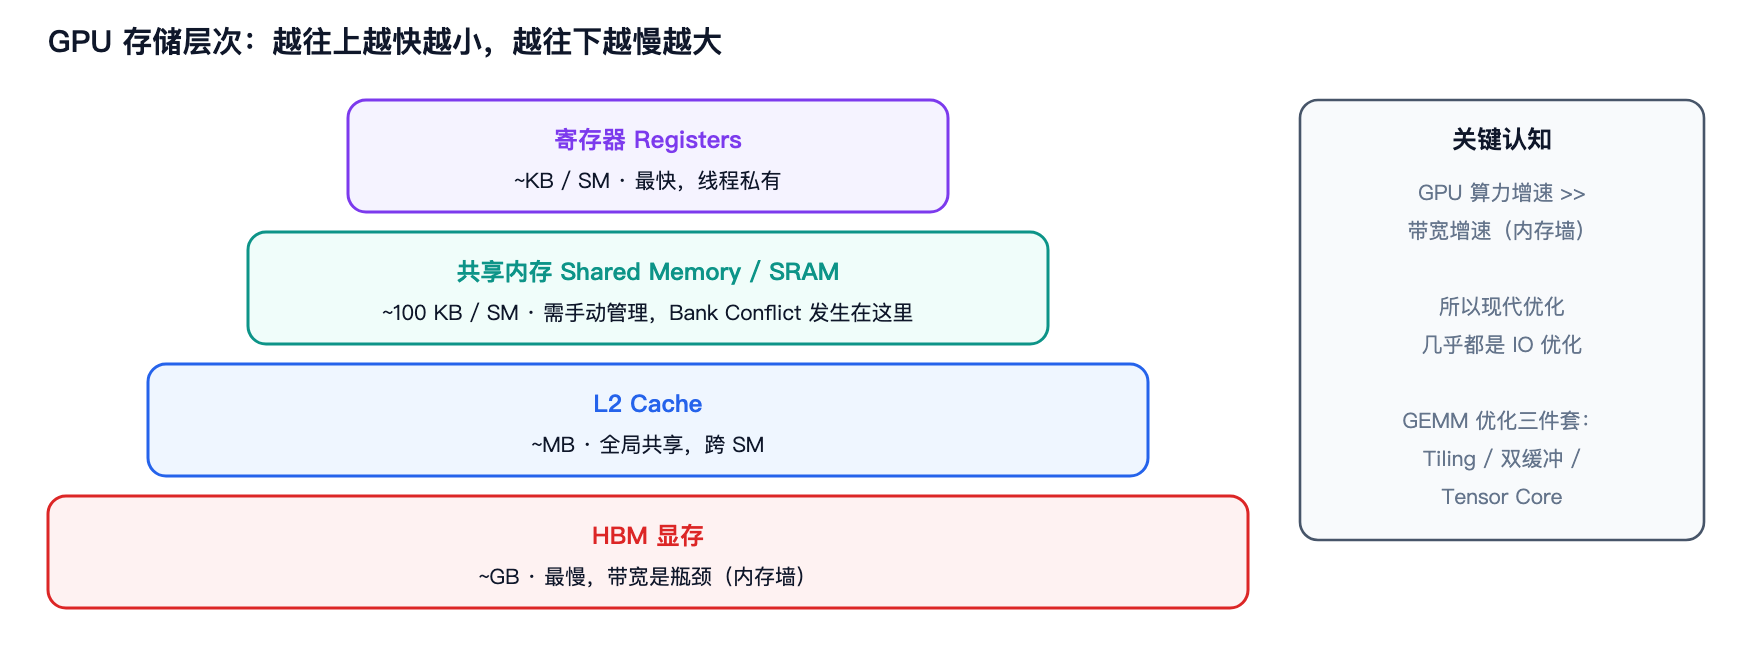 图 3-3 · GPU 存储层次:越往上越快越小,越往下越慢越大
术语解释:
- Register(寄存器):GPU 最快的存储,线程私有,容量极小(KB 级)。
- Shared Memory(共享内存):SM 内所有线程共享的片上存储,需手动管理,Bank Conflict 就发生在这里。
- L2 Cache(二级缓存):跨 SM 共享的片上缓存,容量 MB 级。
- HBM(High Bandwidth Memory,高带宽显存):GPU 主显存,GB 级,带宽是大多数推理负载的瓶颈。
- 内存墙(Memory Wall):算力增速长期快于带宽增速,导致系统越来越受带宽限制的现象。
- 双缓冲(Double Buffering):在处理当前数据块的同时预取下一块,用计算掩盖访存延迟。
寄存器 (Registers)    ~KB     最快
    ↓
共享内存 / SRAM        ~100KB/ SM   需手动管理,Bank Conflict 就发生在这里
    ↓
L2 Cache              ~MB     全局共享
    ↓
HBM(显存)            ~GB     最慢,带宽是瓶颈
GEMM 优化三件套:Tiling(分块提高数据复用)、双缓冲(Prefetch 隐藏延迟)、Tensor Core(矩阵乘专用单元)。用不用 Tensor Core 通常有数倍差距。