6.2 KV Cache:推理显存大户
KV 块分配、分页寻址与前缀复用
速查:KV Cache 缓存历史 Token 的 Key/Value,避免 Decode 每步重算,但显存占用随「层数 × KV Head 数 × 序列长度 × 并发数」线性增长,高并发时往往超过模型权重。
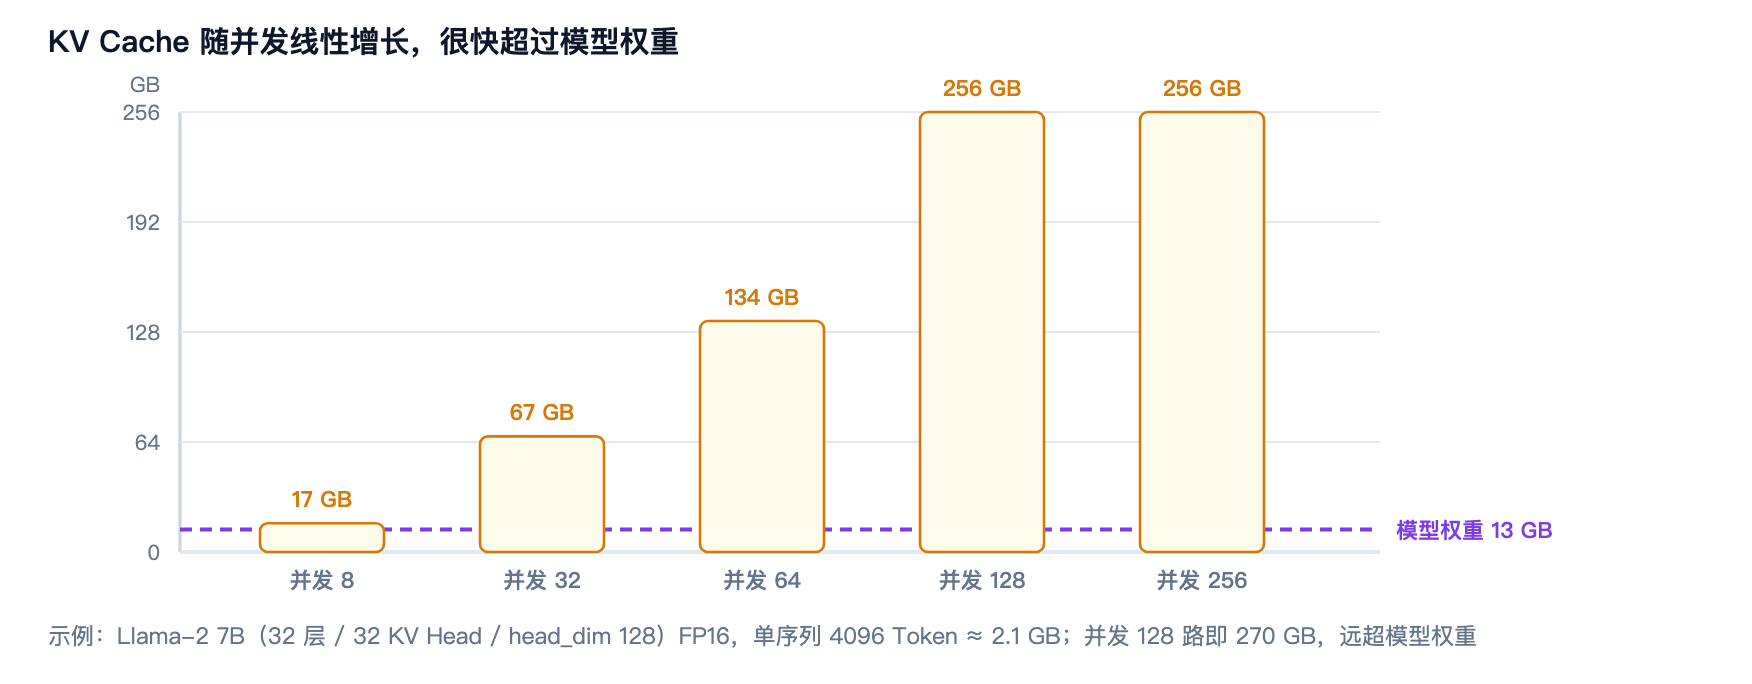 图 1-2 · KV Cache 随并发线性增长,很快超过模型权重(示意数据)
术语解释:
- KV Cache(Key-Value Cache,键值缓存):把每层历史 Token 的 Key 和 Value 张量存下来,Decode 时直接复用,避免重复计算。它是用「显存换计算」的典型手段。
- Head(注意力头):Attention 被切分成多个并行的子空间,每个子空间一个 Head;num_kv_heads 指 K/V 的 Head 数量。
- head_dim(头维度):单个 Head 的向量维度。
KV Cache 大小公式:
KV_bytes = 2 × num_layers × num_kv_heads × head_dim × seq_len × batch × dtype_bytes
           ↑
       K 和 V 各一份
举个具体例子:Llama-2 7B(32 层、32 KV Head、head_dim 128)FP16,单序列 4096 Token:
2 × 32 × 32 × 128 × 4096 × 2 bytes ≈ 2.1 GB
看起来不大,但如果并发 128 路,就是 270 GB——远超模型权重本身(13 GB)。这就是为什么 KV Cache 优化是推理系统的核心命题。
追问:KV Cache 为什么不能省?
如果不缓存历史 K/V,每一步都要重复做历史 token 的 QKV 投影及前面各层计算;保留缓存后仍需对历史 K/V 做 Attention 读取,单步成本并非 O(1)。缓存可以压缩、换出或按模型结构调整,是否重算取决于显存和计算权衡。