8.2 Continuous Batching:每轮重组活跃请求
分页、连续批处理、前缀缓存、图与编译
速查:Continuous Batching(连续批处理,也叫 Iteration-level Batching,迭代级批处理)让请求在每次迭代动态加入/退出 Batch,而不是等整批请求都结束。核心是提升 GPU 利用率——Decode 阶段权重读取被更多请求分摊。
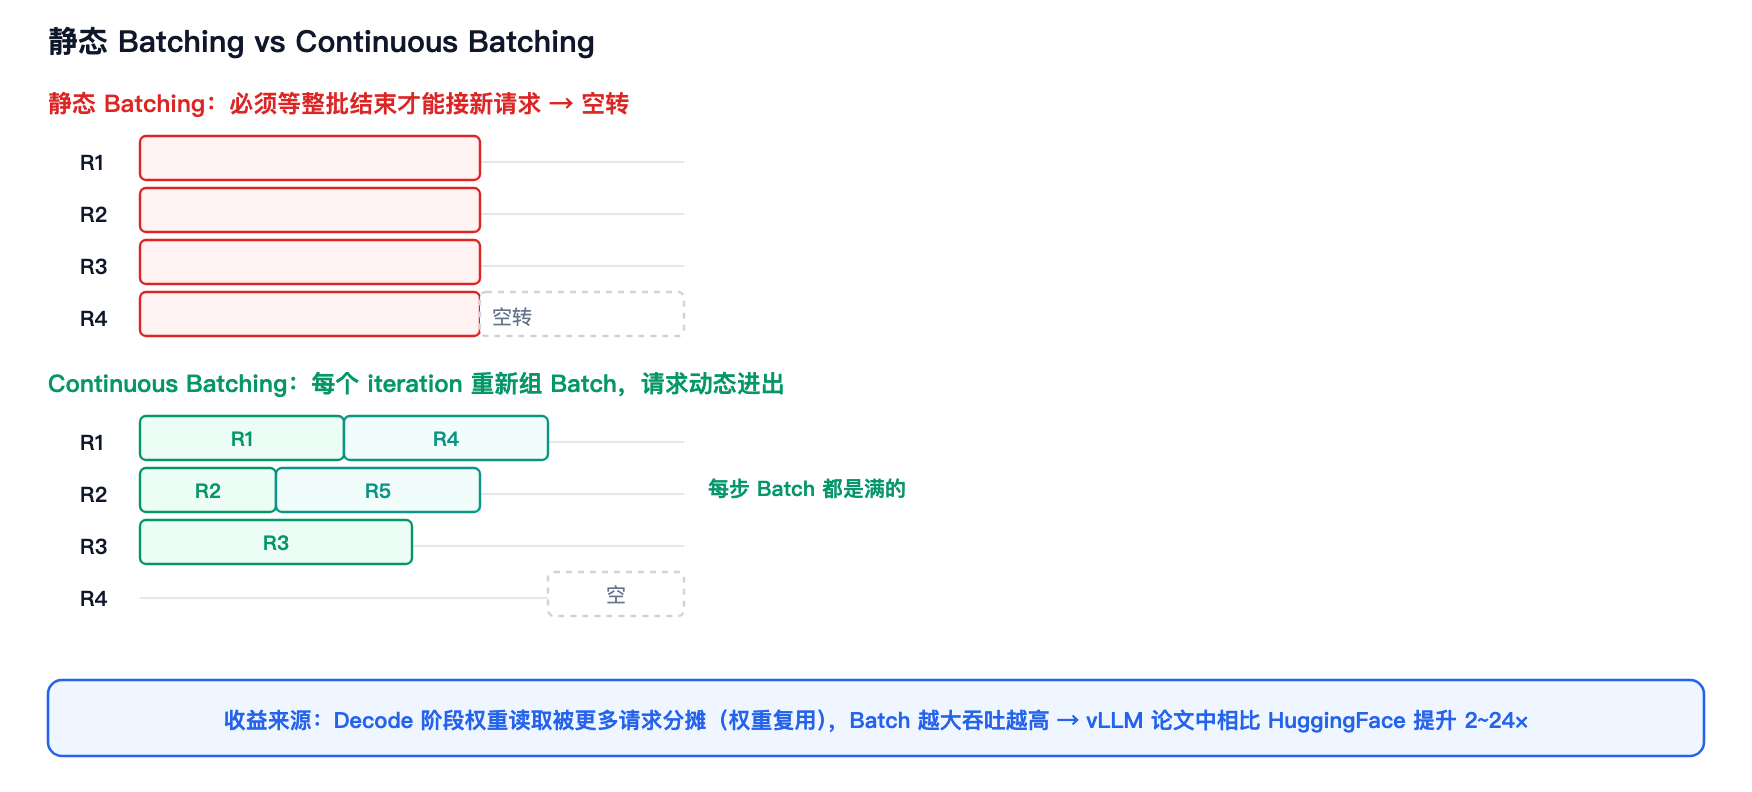 图 5-1 · 静态 Batching 会空转;Continuous Batching 每步都重新组批,Batch 可以动态补位
术语解释:
- Continuous Batching(连续批处理):由 Orca 系统提出,在每次迭代(每生成一个 Token)结束时重新组 Batch。
- Static Batching(静态批处理):传统做法,整批请求必须一起开始、一起结束。
- Iteration(迭代):一次前向计算,Decode 阶段每迭代生成一个 Token。
- GPU 利用率(GPU Utilization):需要明确是驱动显示的 busy 时间、SM active 还是运算单元利用率;Batch 不满时大量算力被浪费。
静态 Batching(传统):
  Batch = [R1, R2, R3],必须等全部生成完才能接新请求
  → R1 早结束,它占的位置就浪费了(GPU 空转)

Continuous Batching(Orca / vLLM):
  每个 iteration 结束都重新组 Batch
  R1 结束 → 立刻用 R4 补位
  → 尽量减少空槽,仍受请求到达与 KV 容量限制
码 5-1 · Continuous Batching 的调度主循环
while waiting or running:
    budget = max_num_batched_tokens
    decode_seqs, budget = schedule_decode(running, budget)      # 先排 decode:每请求 1 token
    prefill_seqs, budget = schedule_prefill(waiting, budget)    # 剩余预算再排 prefill

    logits = model_runner.run(decode_seqs + prefill_seqs)       # 一轮前向,两批共享预算

    for seq in decode_seqs:                                     # 谁结束,谁立刻退出
        if seq.is_finished():
            running.remove(seq)
    for seq in prefill_seqs:                                    # prefill 完,立刻转 running
        running.append(seq)
关键就在最后两个循环:退出与加入都发生在「每一轮迭代之后」,而不是等整批跑完——这就是 Continuous Batching 与 Static Batching 的全部差别。另外注意
decode与prefill共用同一个budget(max_num_batched_tokens)和序列槽位,不是各拿一份,所以长 Prompt 的 Prefill 只能吃掉 Decode 剩下的预算,不会阻塞已在跑的请求。
追问:Continuous Batching 的调度怎么做?
一次
schedule()通常返回两批——Decode 批和 Prefill 批,共享同一个 Token Budget(Token 预算,一轮允许处理的最大 Token 数)。先排 Decode(每个 running 请求 1 Token),剩余预算再排 Prefill,这样长 Prompt 不会阻塞已在跑的请求。running 队列用 round-robin(轮询) 防止饥饿;显存不够时抢占(Preemption) 部分请求(释放 KV),靠 Prefix Cache 或重算恢复。