5.2 GQA / MQA
GQA/MLA、在线 Softmax 与 FlashAttention
速查:GQA 让多个 Query Head 共享一组 K/V Head(num_kv_heads < num_q_heads),MQA 是极端情况(只有 1 组 K/V)。直接减少 KV Cache 大小和 Attention 的 K/V 访存量;质量影响取决于模型训练与 Head 配置。
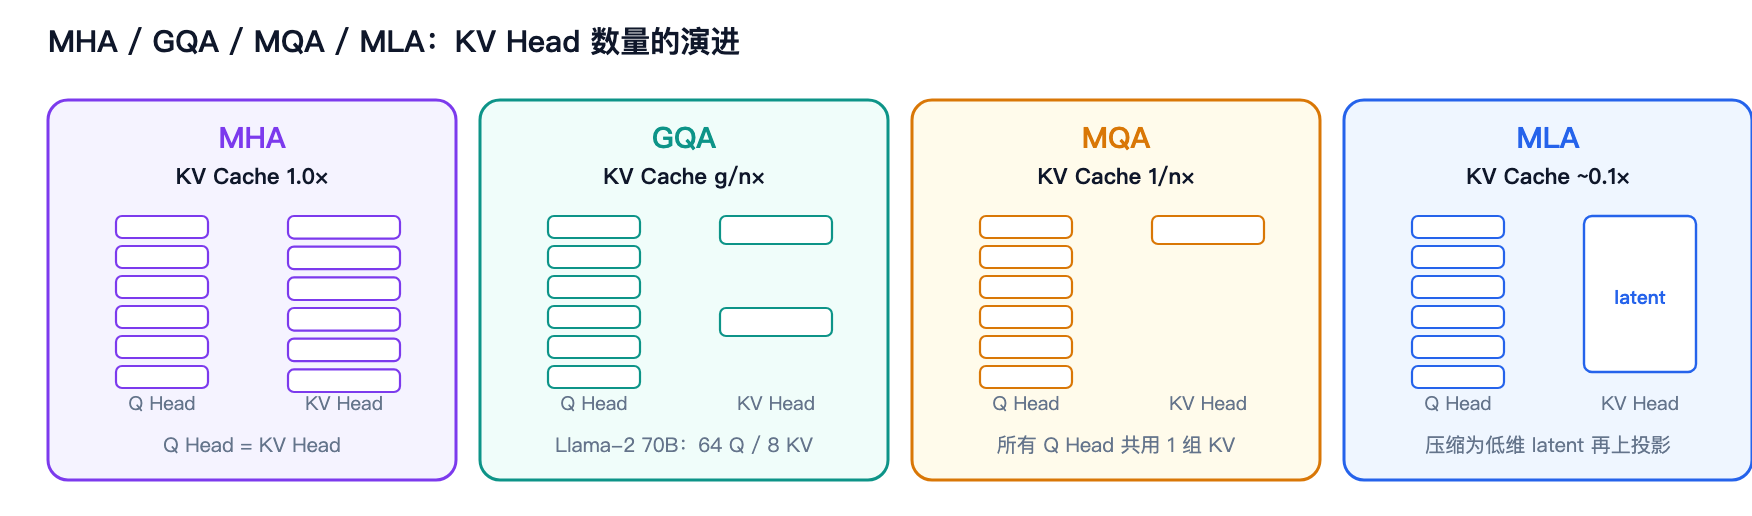 图 2-2 · 四种注意力变体的 Q Head / KV Head 配比与 KV Cache 压缩比
术语解释:
- MHA(Multi-Head Attention,多头注意力):标准注意力,Q/K/V 的 Head 数相同。
- MQA(Multi-Query Attention,多查询注意力):所有 Query Head 共享唯一一组 K/V。
- GQA(Grouped-Query Attention,分组查询注意力):Query Head 分组,每组共享一组 K/V,是 MHA 与 MQA 的折中。
MHA (标准)      Q: n 组   K/V: n 组        KV Cache: 1.0×
GQA (分组)      Q: n 组   K/V: g 组 (g<n)  KV Cache: g/n×
MQA (极端)      Q: n 组   K/V: 1 组        KV Cache: 1/n×
码 2-2 · GQA 的 K/V 广播
def repeat_kv(k, num_q_heads):
    """GQA:把 g 组 K/V 广播成 n 组。只在计算时复制,KV Cache 里始终只存 g 组。"""
    if k.shape[1] == num_q_heads:                 # 已经是 MHA,无需广播
        return k
    repeat = num_q_heads // k.shape[1]
    return (k[:, :, None, :, :]
            .expand(-1, -1, repeat, -1, -1)       # expand 是零拷贝视图
            .reshape(k.shape[0], num_q_heads, k.shape[2], k.shape[3]))  # reshape 才真正复制
expand不占显存、reshape才物化——所以 GQA 省下的是 KV Cache 容量和 K/V 的访存带宽,省不掉 Q 侧那一份注意力计算量。面试被追问「GQA 到底省了什么」时,这个区分是加分点。
- Llama-2 70B:64 个 Q Head,8 个 KV Head → KV Cache 直接降到 1/8。
- Llama-3、Qwen 等新一代模型普遍采用 GQA。
- 代价:K/V 表达能力下降,但实验表明在合理分组下质量损失很小。
追问:GQA 相比 MQA 好在哪?
MQA 压得太狠(1 组 K/V),质量下降明显且训练不稳定;GQA 在 MQA 的压缩比和 MHA 的质量之间取折中,可以按需调节 KV Head 数(如 8 组),是当前的工业标准。