8.4 Chunked Prefill 与统一 Token Budget
分页、连续批处理、前缀缓存、图与编译
Scheduler 的两个预算与四种状态
请求状态可简化为 WAITING → RUNNING → FINISHED,显存不足时 RUNNING → PREEMPTED → WAITING/RUNNING。调度一次迭代要同时满足 token 预算(本轮前向的总 token)和 KV 块预算(本轮新增/保留物理页);仅检查其中一个会在高并发时 OOM 或形成空转。
def schedule_step(waiting, running, token_budget, pool):
    batch = []
    # 先处理正在运行的请求以保护 TPOT;策略可按 SLA 调整。
    for req in list(running):
        want = min(req.pending_tokens(), token_budget)
        if want == 0:
            continue
        try:
            table = pool.reserve(req.id, req.computed + want)
        except MemoryError:
            continue  # 实际系统可能抢占、重算、换出或拒绝
        batch.append((req, want, table))
        token_budget -= want
    for req in list(waiting):
        want = min(req.prompt_remaining(), token_budget)
        if want == 0:
            break
        try:
            table = pool.reserve(req.id, req.computed + want)
        except MemoryError:
            break
        waiting.remove(req)
        running.append(req)
        batch.append((req, want, table))
        token_budget -= want
    return batch
真实 vLLM V1 的 Scheduler 将请求进度表示为已计算 token 与待计算/投机 token 的差,统一覆盖 Chunked Prefill、Prefix Cache 和 Speculative Decode。读取 vLLM Scheduler.schedule 时按五步找:running/waiting → 本轮 token 数 → KV 分配 → SchedulerOutput → 结果写回。上述代码是教学伪代码,并非逐行复制框架实现。
服务指标:同时画 TTFT、TPOT 的 P50/P95/P99 与输出 token/s,并记录 waiting/running 数、KV free blocks、preemption 次数、prefix hit tokens。总 token/s 变高而 P99 TPOT 变差时,优先检查长 Prefill 是否占用整轮预算、调度公平性和输出回传积压。追问:为何 GPU 利用率高仍可能服务差?SLA 由排队、每轮时延与尾延迟决定。
Chunked Prefill
速查:把长 Prompt 的 Prefill 拆成多个 Chunk(块) 分批执行,避免一次性占满显存(OOM),同时可以和 Decode 混在同一 Batch 里,降低 TBT 抖动。
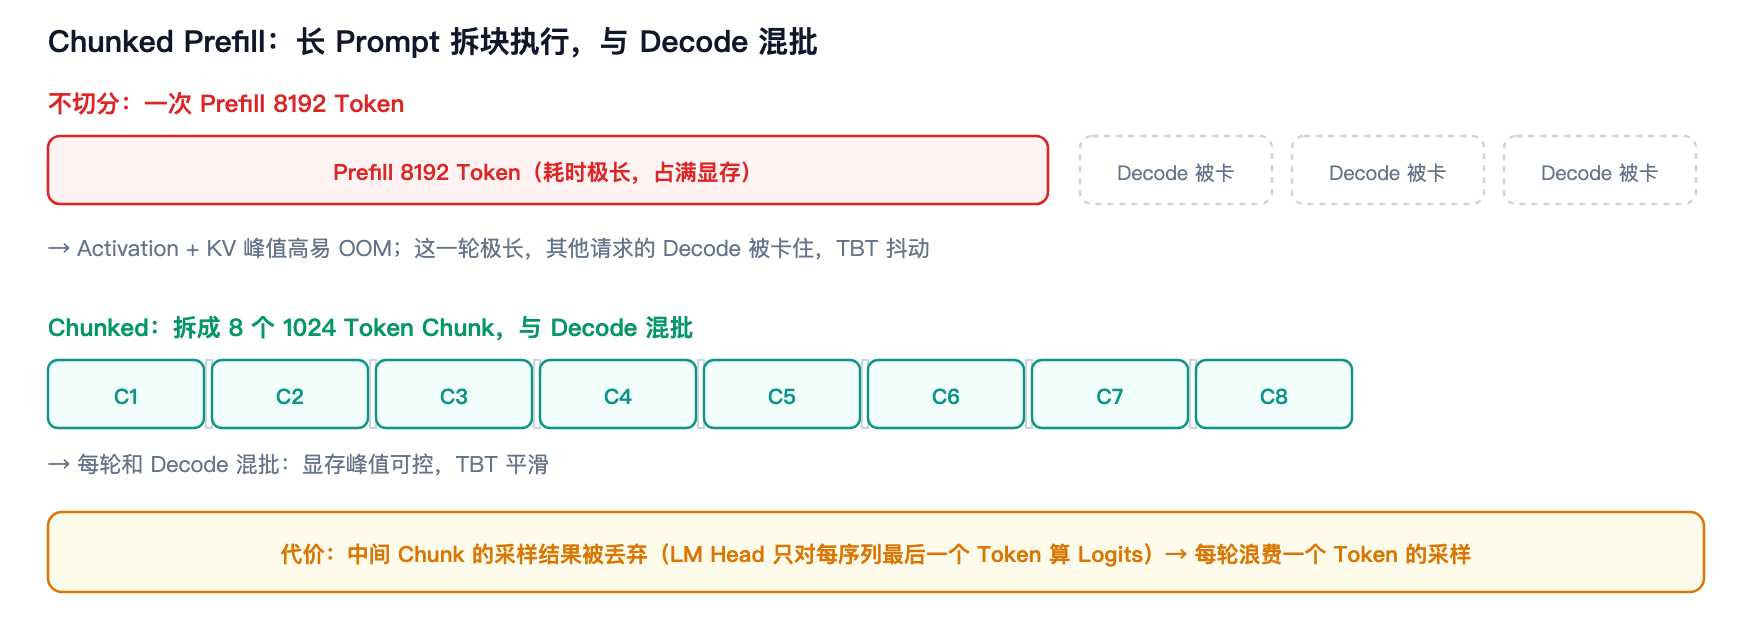 图 5-2 · 长 Prompt 拆块后与 Decode 混批,显存峰值可控、TBT 平滑
术语解释:
- Chunked Prefill(分块预填充):把一次大 Prefill 切成多个小 Chunk 分轮执行。
- Head-of-Line Blocking(队首阻塞):队列头部的大请求阻塞了后面小请求的处理。
不切分:8192 Token Prompt → 一次 Prefill
  → Activation + KV 峰值高,容易 OOM
  → 这一轮耗时极长,其他请求的 Decode 被卡住(TBT 抖动)

Chunked:8192 拆成 16 个 512 Token Chunk
  → 每个 Chunk 和 Decode 混批执行
  → 显存峰值可控,TBT 平滑
代价:
- 中间 Chunk 不应采样;实现可跳过其中的 LM Head/logits。代价主要是更多调度与 Kernel 边界、可能的算子效率变化。
- 调度更复杂,需要处理「未完成的 Prefill 请求」在队列中的位置。
码 5-2 · Chunked Prefill 的切块与「中间块不采样」
CHUNK = 512
for start in range(0, len(prompt), CHUNK):
    chunk = prompt[start:start + CHUNK]
    is_last = start + CHUNK >= len(prompt)
    logits = model(prefill_chunk(chunk, kv_cache), return_logits=is_last)
    if is_last:
        next_token = sample(logits)
中间 Chunk 只推进 KV,不做采样;是否执行 LM Head 取决于实现。只有最后一个 Chunk 的末位置 logits 用于首次采样。
追问:Chunked Prefill 和 Continuous Batching 什么关系?
是互补的。Continuous Batching 解决「请求动态进出」,Chunked Prefill 解决「单个长请求内部怎么切分以平滑调度」。两者一起用才能既高吞吐又低抖动(代表实现:Sarathi-Serve)。
调度器设计要点
面试如果让你「设计一个推理调度器」,按这个框架答:
- 预算(Budget):Token Budget 和 Sequence Slot 共享,Decode 优先、Prefill 吃剩余。
- 公平性(Fairness):Round-robin 防饥饿;被抢占请求插队首(比新请求优先恢复)。
- 内存准入(Admission):
can_allocate试探 → 逐步缩小 Chunk 直到可行 → 增量分配 KV(避免按最大长度预留)。 - 抢占(Preemption):只在必要时触发;只抢占本轮尚未执行的 victim,避免释放正在使用的 Block Table。
- 缓存(Cache):Prefix Cache 优先,命中即省 Prefill。
- 流式与 SLO:Chunked Prefill 平滑 TBT,满足延迟约束。
术语解释:
- Admission(准入):判断一个请求当前是否有足够资源可以进入执行。
- Victim(牺牲者):被选中执行抢占、需要释放资源的请求。
- Sequence Slot(序列槽位):一轮调度中允许容纳的最大序列数。