12.4 Data Parallel / Expert Parallel:副本、专家与负载均衡
TP、PP、DP、EP 与 Ray 多节点实践
Dense 模型能放进一个 TP×PP 副本后,DP 复制该副本以扩展请求吞吐。路由结合队列、可用 KV 和缓存亲和,不让一台热副本拖累整体 SLO。MoE 的 EP 在副本内部重新分发 token,检查 expert 负载与跨节点 All-to-All。
原理
速查:MoE 在 Transformer 的 FFN 中引入多个 Expert(专家,指独立的 FFN 子网络),Router(路由器,负责给 Token 打分并选择专家的模块) 为每个 Token 稀疏选择 Top-K(分数最高的 K 个) Expert,从而用较小的 Activated FLOPs 获得更大的模型容量。
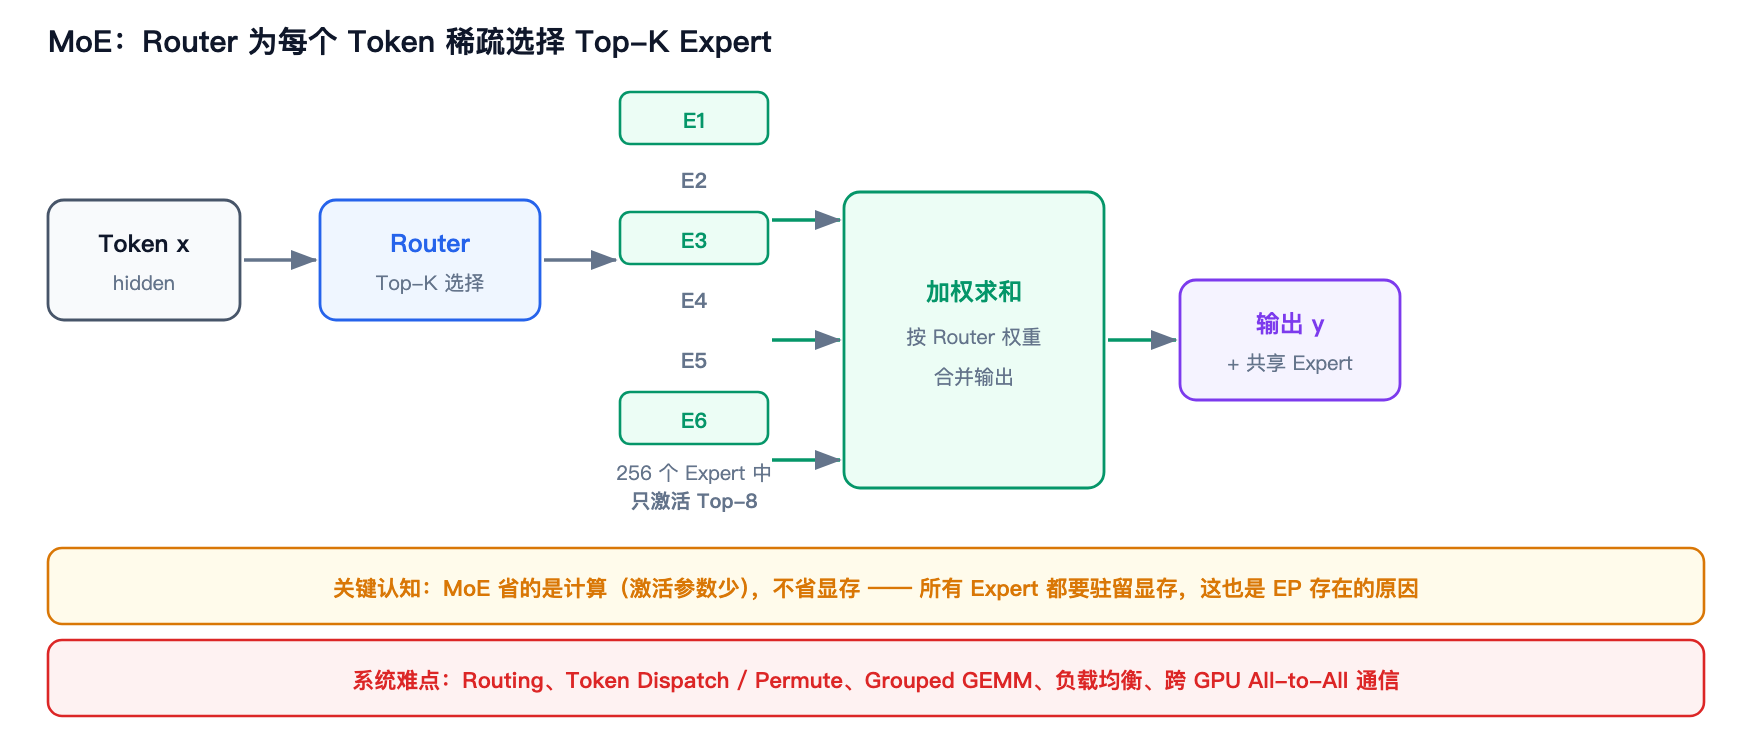 图 7-1 · Router 为每个 Token 选择 Top-K Expert,加权合并后输出
术语解释:
- MoE(Mixture of Experts,混合专家):用多个专家网络 + 稀疏路由替代单一 FFN 的模型结构。
- Router / Gate(路由器 / 门控):计算每个 Token 对各 Expert 的权重并选出 Top-K 的模块。
- Top-K:取分数最高的 K 个;MoE 中 K 通常为 1~8。
- Activated FLOPs(激活计算量):单个 Token 实际触发的计算量,MoE 中只算被选中的 Expert。
- 共享专家(Shared Expert):所有 Token 都会经过的专家,用于提升泛化并稳定路由(DeepSeek-V3 采用)。
- Auxiliary Loss(辅助损失):训练时用于约束专家负载均衡的额外损失项。
Dense FFN:  x → FFN → y                    (每个 Token 都过全部参数)
MoE FFN:    x → Router → Top-K Expert → 加权求和 → y
                 ↑
        每个 Token 只激活 K 个 Expert(如 8 选 2、256 选 8)
代表模型:
| 模型 | 总参数 | 激活参数 | 专家配置 |
|---|---|---|---|
| Mixtral 8×7B | 47B | 13B | 8 Expert,Top-2 |
| DeepSeek-V3 | 671B | 37B | 256 路由 Expert + 1 共享,Top-8 |
MoE 与 Dense 的区别(面试高频对比)
术语解释:Dense(稠密模型) 指每个 Token 都经过全部参数的常规模型,与 MoE 的稀疏激活相对。
| 维度 | Dense | MoE |
|---|---|---|
| 每 Token 经过的参数 | 全部 | Top-K Expert |
| 总参数 vs 激活参数 | 接近 | 差距巨大 |
| 单 Token 计算量 | 与总参数成正比 | 与激活参数成正比 |
| 显存 | 模型大小决定 | 总参数决定(全部 Expert 都要装) |
| 系统难点 | 大 GEMM | Routing、Dispatch、Grouped GEMM、负载均衡、All-to-All |
| 推理复杂度 | 相对简单 | 复杂很多 |
关键认知:MoE 省的是计算,不是显存。所有 Expert 都要加载到显存,所以 MoE 对显存容量要求反而更高(这也是 EP 存在的原因)。
系统难点
| 难点 | 说明 |
|---|---|
| Routing(路由) | Router 计算开销小但引入额外依赖,需与 Attention 重叠 |
| Token Dispatch / Permute(Token 分发 / 重排) | 把 Token 按 Expert 分组重排,产生大量不规则访存 |
| Grouped GEMM(分组矩阵乘) | 每个 Expert 的 Batch 大小不同,需要专门的分组 GEMM Kernel |
| 负载均衡(Load Balancing) | 某些 Expert 过热会导致个别 GPU 成为瓶颈(需 aux loss / 容量因子) |
| All-to-All 通信 | EP 下 Token 要跨卡路由到专家,通信量巨大 |
EP 与通信优化
- EP(Expert Parallel):把不同 Expert 放到不同 GPU,Token 通过 All-to-All 送到目标卡。
- 通信优化:DeepEP(DeepSeek 开源)做了大量 All-to-All 优化;通信与计算重叠(把 Dispatch/Combine 与 Attention/GEMM 并行)。
- 共享专家:DeepSeek-V3 保留 1 个共享 Expert,所有 Token 都过,提升泛化并稳定路由。
追问:MoE 推理为什么比 Dense 难做?
Dense 的难点是「大 GEMM」,是规整的计算问题;MoE 的难点是「路由 + 不规则访存 + 负载不均 + 跨卡通信」,是系统问题。尤其 EP 下 All-to-All 通信很容易成为瓶颈,且 Expert 负载不均衡会导致部分 GPU 空转。