11.1 核心原理:Draft + Verify 与 Rejection Sampling
精确采样、Draft Tree、收益边界与 vLLM 实战
速查:先用成本更低的方法生成多个候选 Token(Draft),再由主模型一次性并行验证,从而减少 Decode 阶段的串行 Forward 次数。
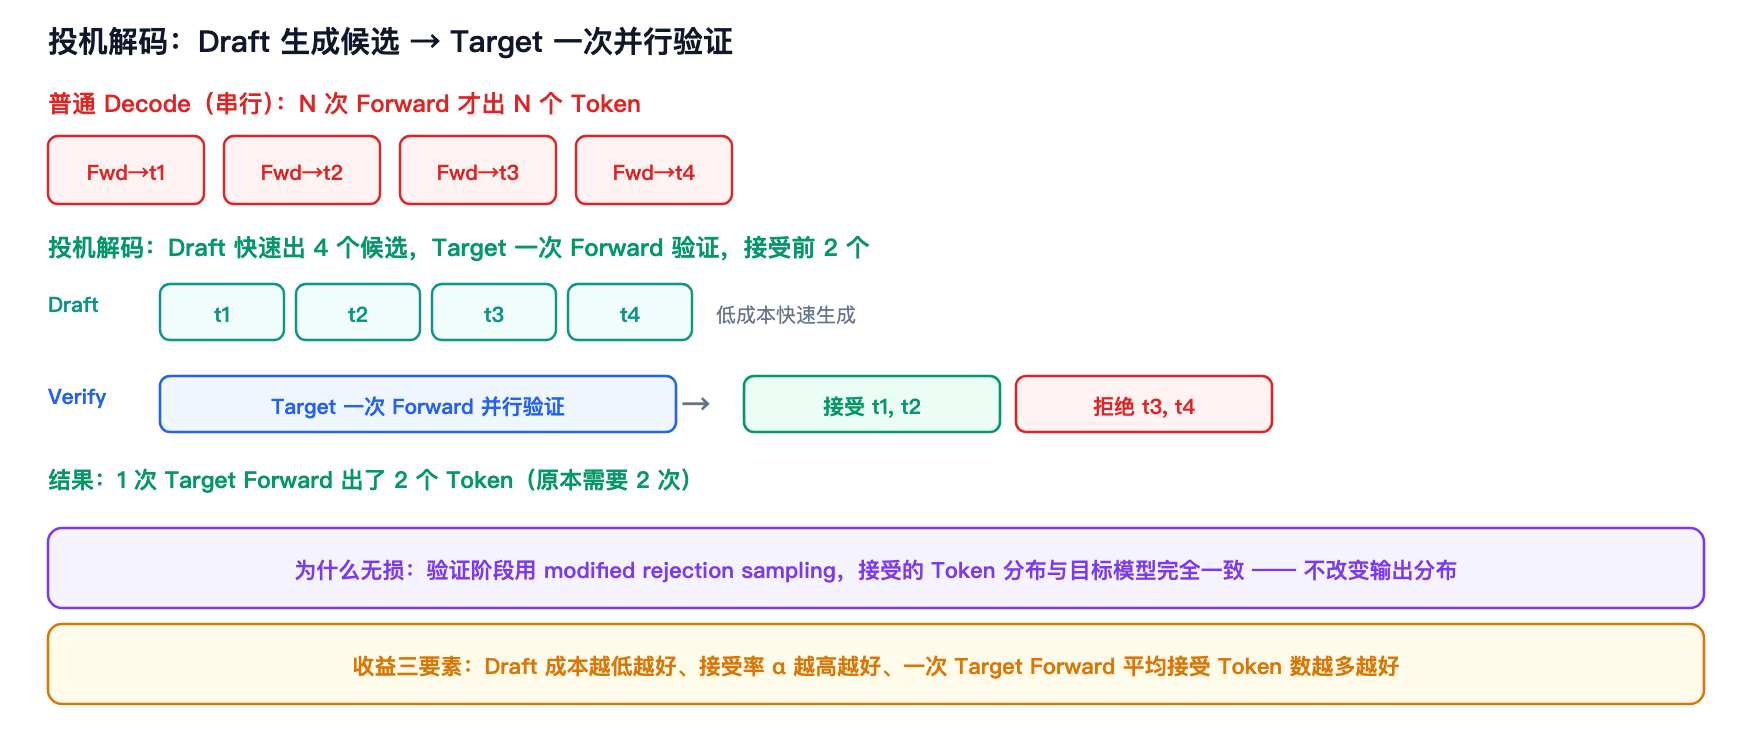 图 8-1 · Draft 快速生成候选,Target 一次 Forward 并行验证并接受前 k 个
术语解释:
- 投机解码(Speculative Decoding):用低成本模型生成候选、由目标模型并行验证的加速范式。
- Draft Model(草稿模型):生成候选 Token 的轻量模型。
- Target Model(目标模型):真正要部署的大模型,负责验证候选。
- Forward(前向):一次完整的前向计算。
- Accept / Reject(接受 / 拒绝):验证阶段判定候选 Token 是否被采纳。
- Acceptance Rate(接受率,α):候选 Token 被接受的比例,是决定加速比的关键。
- modified rejection sampling(改进拒绝采样):一种采样修正方法,保证接受结果的分布与目标模型完全一致。
普通 Decode(串行):
  Forward → t1 → Forward → t2 → Forward → t3 → ...   (N 次 Forward 出 N 个 Token)

投机解码:
  Draft 快速生成 t1,t2,t3,t4(低成本)
  Target 一次 Forward 并行验证这 4 个候选
  → 接受前 k 个(如接受 t1,t2),拒绝后续
  → 接受 t1,t2,再产生一个修正 Token;本轮共输出 3 个 Token
11.1.1 为什么可以一次验证多个候选
Target 无法提前知道自己的后续采样结果,但 Draft 已经提供了一整条候选。对 ctx+d₁+…+dγ 做带 causal mask 的前向,位置 i 只能看到 ctx+d<i,因此得到的正是该候选前缀下的条件分布。各位置层内可以并行计算;是否保留候选仍必须按顺序决定,一旦拒绝,后面的分布基于错误前缀,全部作废。经典投机解码论文
p₁ = Target(. | ctx)                  # 检查 d₁
p₂ = Target(. | ctx,d₁)               # 检查 d₂
…
pγ = Target(. | ctx,d₁,…,dγ-1)        # 检查 dγ
pγ+1 = Target(. | ctx,d₁,…,dγ)        # 全接受后的 bonus token
实现要核对 logits 的位置偏移:d_i 输入位置的 logits 预测的是下一个 token,不是 d_i 自己。首位置分布来自候选前的边界 token / 已缓存 logits;一次验证也可以把尚未计算的边界 token 一起输入。Kernel shape、KV 进度和 logits 对齐应一起核查。
11.1.2 Greedy 与随机采样的验收不同
贪心解码逐位置比较 d_i == argmax(p_i);第一个不匹配处输出 Target 的 argmax,之后停止。前缀一致、tie-breaking 一致且实现数值行为一致时,可复现 Target 的贪心路径。
随机采样令 Draft 实际采样分布为 q_i,Target 实际采样分布为 p_i,两者都已应用各自的温度、top-k / top-p 和约束。接受 Draft token d_i~q_i 的概率为:
a_i(d_i) = min(1, p_i(d_i)/q_i(d_i))
拒绝后:r_i(v) = max(p_i(v)−q_i(v),0) / Σ_u max(p_i(u)−q_i(u),0)
必须保存 实际提议分布 q,不能在 top-p 采样后用未经截断的 softmax 概率当分母。Target 的约束、惩罚等处理也应按每个候选前缀重新生效。
码 10-1 · 单条候选链的完整教学伪代码
# 接口返回的是归一化后的实际采样分布。
# ctx 表示逻辑 token 序列;KV 写入 / 回滚在 11.4.7 单独说明。
draft, q_list = [], []
for i in range(gamma):
    q_i = draft_distribution(ctx + draft)  # Draft 依赖此前提议的 token
    d_i = sample(q_i)
    draft.append(d_i)
    q_list.append(q_i)

# 正确对齐候选前缀的 γ+1 个分布,包括首位置和 bonus 位置。
p_list = target_verify_distributions(ctx, draft)
accepted = 0
for i, d_i in enumerate(draft):
    p_i, q_i = p_list[i], q_list[i]
    # d_i 来自 q_i,所以理论上 q_i[d_i]>0;数值实现须保留该性质。
    accept_prob = min(1.0, float(p_i[d_i] / q_i[d_i]))
    if uniform_0_1() < accept_prob:
        accepted += 1
    else:
        residual = (p_i - q_i).clamp_min(0)
        # 精确算术下,发生拒绝意味着 residual.sum()>0。
        # 生产实现还需处理浮点舍入导致的数值边界。
        next_token = sample(residual / residual.sum())
        break
else:
    # 全接受:从最后一个候选之后的 Target 分布生成额外 token。
    next_token = sample(p_list[gamma])

emitted = draft[:accepted] + [next_token]
# EOS / stop / max_new_tokens 可让这一轮提前终止,不能强行输出 bonus。
不能对固定 ctx 调用 γ 次独立 Draft step,那不构成自回归候选链。上述代码抽象了分布生成,尚未实现 batched scheduler、分页 KV 和 RNG 管理,不能直接当生产 serving loop。
11.1.3 修正为什么能保持 Target 分布
对某个 token v,被提议且接受的概率质量是:
q(v) × min(1,p(v)/q(v)) = min(p(v),q(v))
拒绝总概率 R = 1 − Σ_v min(p(v),q(v)) = Σ_v max(p(v)−q(v),0)
拒绝后给 v 的质量 R×r(v) = max(p(v)−q(v),0)
最终质量 = min(p(v),q(v)) + max(p(v)−q(v),0) = p(v)
教学例:p=(0.6,0.4)、q=(0.8,0.2)。第一种 token 接受概率 0.75,第二种为 1,接受质量为 (0.6,0.2);拒绝概率 0.2,修正分布为 (0,1),最终得到 (0.6,0.4)。若拒绝后直接从 p 重采样,会得到 (0.72,0.28),就偏了。
在每个已接受前缀下重复这个论证,得到完整自回归序列的分布一致性。这里的「无损」是相对于 当前 Target 的实际采样分布,不保证相同随机种子逐 token 相同;若 Target 自身已量化,也不意味着恢复了原始 BF16 模型的分布。