10.1 量化基础:对称 / 非对称、粒度、PTQ vs QAT
量化原理、低比特 Kernel、KV 压缩与部署选型
学习主线:先理解量化误差怎样影响输出,再看算法如何分配误差,最后判断 Kernel 能否把少读的字节变成实际收益。本章量化部分按「基础 → W8A8 → Weight-only INT4 → KV Cache → 低比特浮点 → 选型与部署」展开。
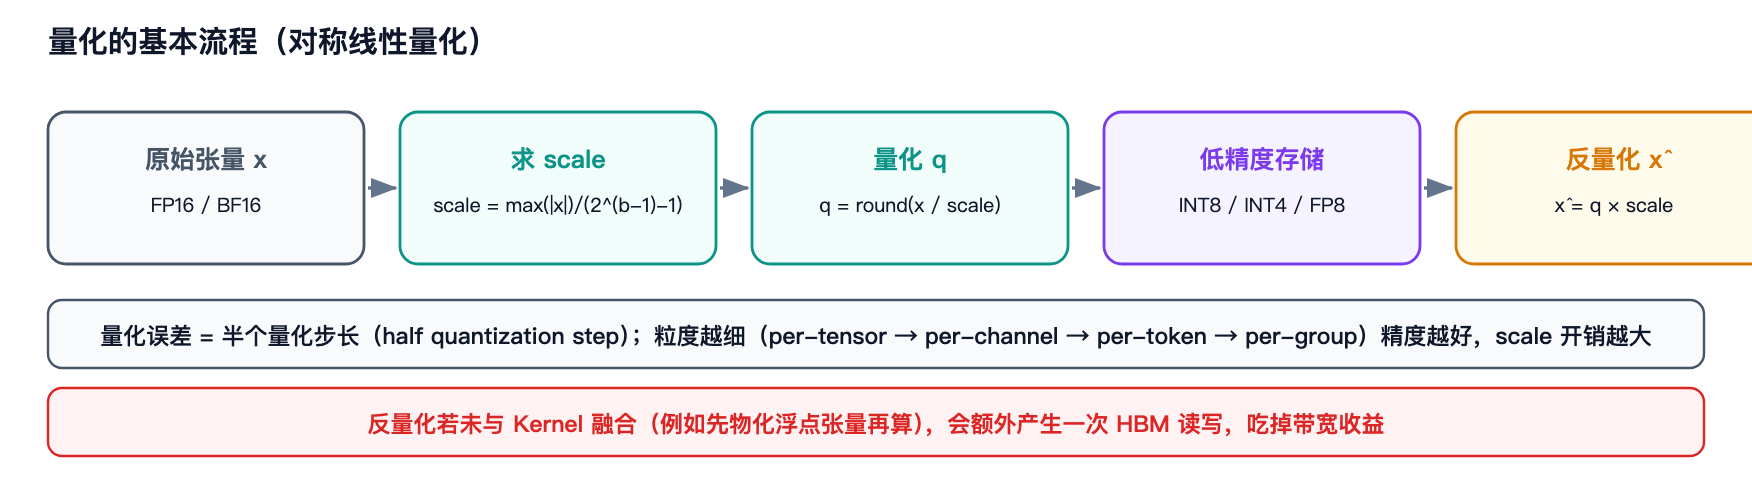 图 2-1 · 对称线性量化的流程;部署时尽量把反量化融合进计算 Kernel
10.1.1 量化映射与误差从哪里来
Scale(缩放因子)确定量化网格间距;Zero-point(零点)确定浮点零对应哪个整数。下式中 x̂ 是还原后的近似值,clip 限制整数范围:
对称量化(这里使用正负对称的整数子集):
  qmax = 2^(b-1) - 1
  s = max(abs(x)) / qmax
  q = clip(round(x/s), -qmax, qmax)
  x̂ = s × q

非对称量化(整数范围 [qmin, qmax]):
  s = (xmax - xmin) / (qmax - qmin)
  z = clip(round(qmin - xmin/s), qmin, qmax)
  q = clip(round(x/s) + z, qmin, qmax)
  x̂ = s × (q - z)
非对称量化的范围统计通常要包含零;常量 / 全零张量需要单独处理 s=0。对称量化无 zero-point 修正,实现简单;非对称量化能更充分利用非零中心分布的编码范围,但点积可能增加零点补偿项。
舍入误差:在没有裁剪、使用最近邻舍入时,标量误差 |x̂−x| ≤ s/2。裁剪误差:用更小范围压制 Outlier 后,范围外的数会饱和,误差可以超过半个 step。不能把这个标量界推广成整层输出或任务质量的保证。
例如绝大多数值在 [-1,1],一个值是 100:INT8 max-abs 的 step 约为 100/127≈0.787,普通值只分到几个刻度。裁剪 Outlier 能改善普通值的分辨率,却会损伤被裁剪的值;GPTQ、AWQ、SmoothQuant 则进一步利用输入统计或等价变换控制输出误差。
码 9-1 · 对称量化参考实现(演示数值,不做 INT4 packing)
import torch

def quantize_sym(x, bits=8, dim=None):
    # dim=-1 对二维 [tokens, channels] 输入表示每个 token 一个 scale。
    # 对四维 KV 输入,则表示每个 (batch, head, token) 向量一个 scale。
    if not 2 <= bits <= 8:
        raise ValueError("示例只支持 2–8 bit 数值范围")
    qmax = 2 ** (bits - 1) - 1
    amax = x.abs().max() if dim is None else x.abs().amax(dim=dim, keepdim=True)
    scale = (amax.float() / qmax).clamp_min(1e-8)
    q = (x.float() / scale).round().clamp(-qmax, qmax).to(torch.int8)
    return q, scale

def dequantize(q, scale):
    return q.float() * scale
这个示例即使 bits=4,也仍用 INT8 容器保存。真正省到 4 bit 需要把两个编码打包进一个 byte,并让 Kernel 认识 packing 顺序、scale 布局和 zero-point;Fake Quantization 的浮点张量不会自动减少显存。
10.1.2 粒度必须说明统计轴
统一线性层约定:X ∈ R^[T,Cin]、W ∈ R^[Cin,Cout]、Y=XW。框架的 Linear.weight 常存为 [Cout,Cin],读论文或源码时先检查是否转置。
| 粒度 | 例子与统计范围 | 主要取舍 |
|---|---|---|
| Per-tensor | 整个张量共享一个 scale | 元数据少;Outlier 容易影响整个张量 |
| Per-token | 每个输入行沿 Cin 统计 |
适应不同 token;运行时需要归约 |
| Per-channel | 例如每个权重输出通道沿 Cin 统计 |
限制通道间干扰;必须写清是输入还是输出通道 |
| Group-wise | 每个输出通道的输入维每 G 个权重一组 |
常用于 INT4;小 group 增加 scale / zero-point 流量 |
| Block-wise | 例如每个二维 tile 或固定长度 micro-block | 需与硬件和 Kernel tile / scale 布局匹配 |
更细粒度通常能改善误差,但不是精度必然单调提高的定理,也可能让反量化与访存更贵。AWQ 的 per-input-channel 等价缩放与最终 INT4 的 group-wise quantization scale是两组不同参数。
10.1.3 PTQ / QAT 与 W/A/KV 是不同维度
| 维度 | 方法 | 含义 |
|---|---|---|
| 获取量化模型 | PTQ(训练后量化) | 不做完整重训;可用校准样本收集统计、搜索 scale 或优化重构 |
| 获取量化模型 | QAT(量化感知训练) | 训练 / 微调时模拟量化误差,常用 STE 近似处理舍入梯度;成本更高 |
| 量化对象 | W4A16 / Weight-only | 权重 4 bit,激活 FP16/BF16;主要减少权重存储与读取 |
| 量化对象 | W8A8 | 权重、激活均 8 bit;INT8 或 FP8 要另外说明,计算收益依赖对应硬件路径 |
| 量化对象 | KV Cache | 压缩请求运行时状态;与权重量化独立,不由 W4A16 自动决定 |
PTQ 的校准集应覆盖业务的输入域与长度分布,并与验证集分开;收集 activation range、通道幅值或输入相关性后,搜索 / 计算量化参数,逐层检查误差,再评估任务质量。无需标签也能统计输入,但不能用同一小组校准样本代替下游验收。
QAT 的 Fake Quant 常做 x → quantize → dequantize → x̂,前向暴露舍入 / 裁剪误差,反向用 STE(Straight-Through Estimator)等近似梯度更新权重。训练仍可能保留浮点主权重;导出时还要生成部署格式并匹配 Kernel。QAT 也不自动保证无损,收益应与额外训练成本一起比较。
Weight-only 常在寄存器中解包 / 反量化,再使用浮点 Tensor Core;它也可能加速推理,不能说「只省显存」。W8A8 不代表 Softmax、Norm、残差、累加和 KV 都变成 8 bit。