12.1 策略总览与训练的差异
TP、PP、DP、EP 与 Ray 多节点实践
通信进入每层时间账本
以两卡 Tensor Parallel 的线性层为例,Column Parallel 把输出通道切分,后续 Row Parallel 把输入通道切分并在输出处归约。理想计算时间下降时,每层 All-Reduce/All-Gather 的启动延迟与传输字节会成为新瓶颈。Pipeline Parallel 按层切分,需要微批填满阶段;Expert Parallel 把 token 经 All-to-All 送到专家所在设备,再逆路由回来。
TP: X → [XW0 | XW1] → 局部 Attention/MLP → All-Reduce
PP: Stage0 → 激活 P2P → Stage1(微批之间交错)
EP: Router → 按 expert 分桶 → All-to-All → Expert GEMM → All-to-All
PD: Prefill Pool → KV transfer(含 block layout/位置)→ Decode Pool
NCCL 排障基线:各 rank 必须按同样顺序进入 collective,shape/dtype/count 必须相容,所有 rank 都要报告前后日志;超时日志里的“最后一个 collective”不一定是最早出错点。先用两 rank、最小张量复现,再加 PP/TP/EP 和动态请求。检查 topology、网络、KV 传输量与通信计算重叠。NCCL 用户指南 与 TensorRT-LLM 的 KV transfer 工作流 可作为实现入口。
并行策略:DP / TP / PP / EP / SP
速查:单卡放不下或要提吞吐时,把模型/数据切到多卡。DP 复制模型切数据;TP 层内切权重(通信量大,优先高速互联);PP 按层切(有 Bubble,需 Micro-batch);EP 切专家(MoE 专用);SP 切序列维度。
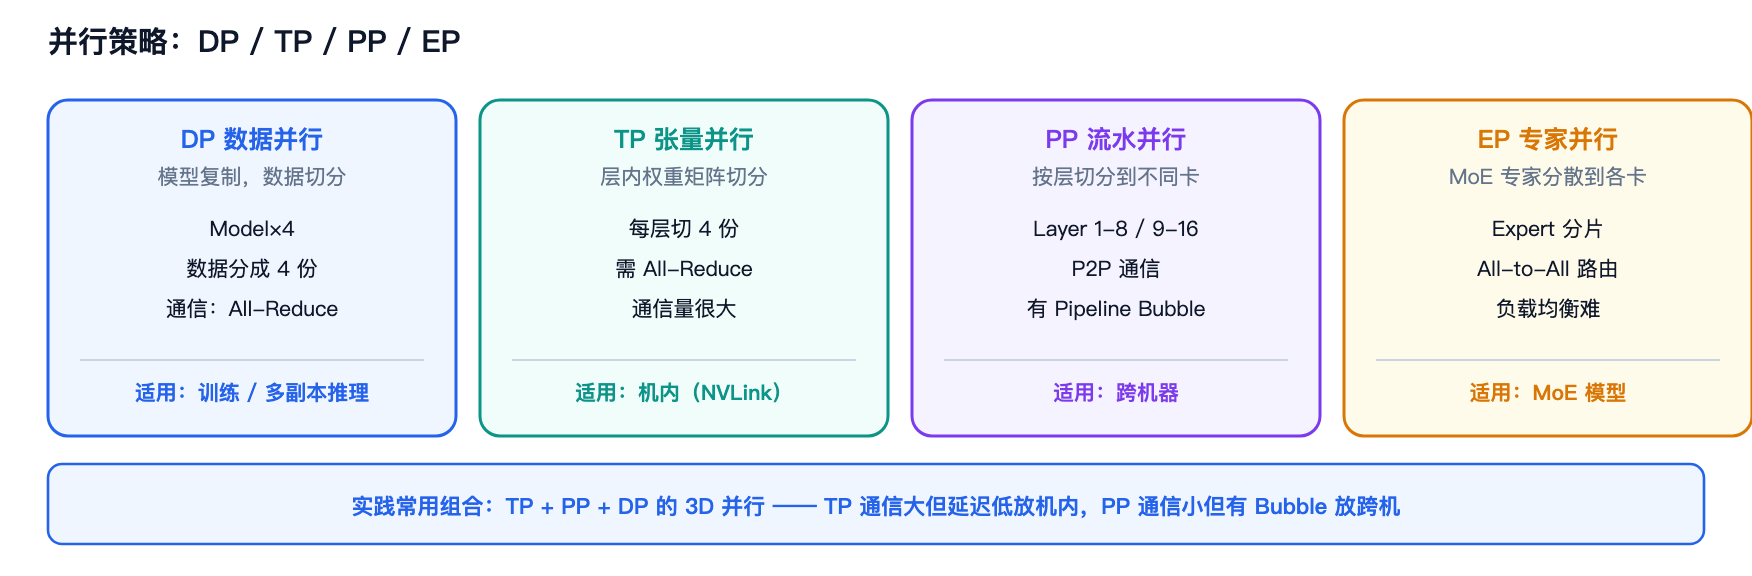 图 5-4 · 四种主要并行策略的切分方式、通信模式与适用场景
术语解释:
- DP(Data Parallel,数据并行):每张卡放一份完整模型,把数据切分到各卡。
- TP(Tensor Parallel,张量并行):把同一层的权重矩阵按维度切到多卡,层内需要频繁通信。
- PP(Pipeline Parallel,流水线并行):按层切分到不同卡,形成流水线。
- EP(Expert Parallel,专家并行):MoE 场景下把不同 Expert 放到不同卡。
- SP(Sequence Parallel,序列并行):沿序列维度切分,常用于降低激活显存。
- Micro-batch(微批次):PP 中把一个大 Batch 拆成多个小批,填充流水线以减少气泡。
- Pipeline Bubble(流水线气泡):流水线启动/排空阶段部分阶段空闲造成的浪费。
- All-Reduce(全归约):所有卡的数据求和后广播回每张卡。
- All-to-All(全交换):每张卡把自己的一部分数据发给所有其他卡,是 EP 的核心通信模式。
- All-Gather / Reduce-Scatter(全收集 / 归约散射):All-Reduce 的两个半边操作,分别用于聚合与分散。
- P2P(Point-to-Point,点对点):相邻卡之间直接传输,PP 使用。
- NVLink:NVIDIA 的 GPU 间高速互联,带宽远高于 PCIe,适合放通信量大的 TP。
- RDMA(Remote Direct Memory Access,远程直接内存访问):跨机器的高性能网络传输技术。
| 策略 | 切什么 | 通信模式 | 通信量 | 适用 |
|---|---|---|---|---|
| DP | 数据(模型复制) | 训练做梯度 All-Reduce;Dense 推理副本独立 | 取决于模式 | 训练 / 推理多副本 |
| TP | 层内权重矩阵 | All-Reduce(每层) | 很大 | 单机内(NVLink) |
| PP | 按层切分 | P2P(相邻 stage) | 小 | 跨机 |
| EP | MoE 专家 | All-to-All | 大 | MoE 模型 |
| SP | 序列维度 | All-Gather / Reduce-Scatter | 中 | 长序列 |
追问:TP 和 PP 怎么选?
TP 通信量大但延迟低,适合放在同一台机器内(NVLink 带宽高);PP 通信量小但会产生 Pipeline Bubble(需要 Micro-batch 填充),适合跨机器。实践中常用 TP + PP + DP 的组合(3D 并行)。
追问:为什么 MoE 要用 EP?
MoE 的专家数量多(DeepSeek-V3 有 256 个),全放一张卡显存不够。EP 把不同专家放到不同卡上,Token 通过 All-to-All 路由到对应专家所在卡。代价是通信成为新瓶颈。
推理 DP 通常把独立请求分给模型副本,不做训练梯度 All-Reduce;TP / PP 的副本内各 rank 必须协同推进同一请求。MoE 中 DP 与 EP 可能组合,不能把 DP 一律理解为互不通信。推理优化还受逐 token 延迟和动态序列长度约束,训练的大 batch 经验不直接适用。
训练补课:ZeRO、FSDP 与通信定位
训练的 DP 每张卡先计算不同样本的梯度,再同步等价的全局梯度,供一致的参数更新;推理 DP 则通常没有反向传播和梯度同步。训练单卡显存要分别列参数、梯度、优化器状态、激活,不能只用“模型权重大小”判断是否放得下。ZeRO-1 分片优化器状态,ZeRO-2 再分片梯度,ZeRO-3 进一步分片参数;分片程度越高,单卡常驻状态越少,前后向取回参数与归约梯度的通信也更关键。PyTorch FSDP 采用参数分片,在计算模块前按需 All-Gather 参数,反向时用 Reduce-Scatter 等方式同步并重新分片梯度;实际粒度和内存峰值取决于 wrap、预取、混合精度与实现配置。DeepSpeed ZeRO · PyTorch FSDP
训练任务 GPU 算力未满时,先把一个 step 切成数据读取、前向、反向、优化器更新及 All-Reduce / All-Gather / Reduce-Scatter;比较各 rank 的时间线。若通信 Kernel 或等待跨越计算区间,检查张量字节数、collective 次序、梯度 bucket、网络 / NVLink 拓扑与最慢 rank;若通信少而设备空闲,回到数据加载、CPU launch 与同步。只看 GPU utilization 不能区分通信等待和算子低效。