1.3 Shared Memory Bank Conflict
SM、Warp、Block、存储层次与占用率
速查:一个 Warp(线程束,GPU 调度的最小线程组,通常 32 个线程) 内多个线程同时访问 Shared Memory,如果地址落在同一个 Bank 的不同地址,访问会被串行化,降低访存效率。
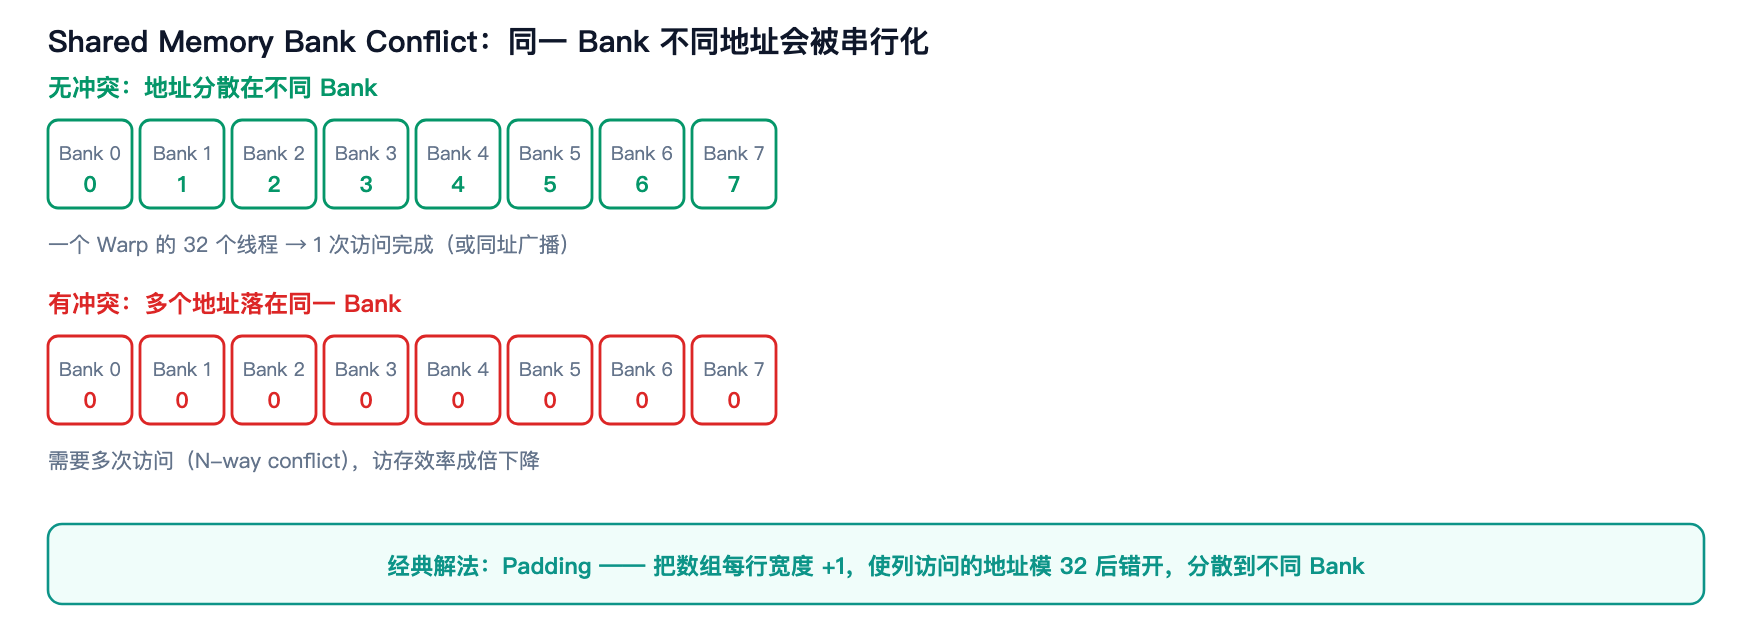 图 3-4 · 地址分散在不同 Bank 时无冲突;多个地址撞同一 Bank 则被串行化
术语解释:
- Bank(存储体):Shared Memory 被划分为 32 个 Bank(通常每个 4 字节宽),可并行访问。
- Bank Conflict(存储体冲突):同一 Warp 内多个线程访问同一 Bank 的不同地址,硬件无法并行,只能串行化。
- Broadcast(广播):若多个线程访问同一 Bank 的同一地址,硬件可一次广播,不算冲突。
- Padding(填充):在数组每行末尾补几个元素,改变地址步长以避开冲突。
- Swizzle(混淆/重排):通过地址位重排打散访问模式,是比 Padding 更现代的解法。
| 场景 | 冲突原因 | 解法 |
|---|---|---|
列访问 [row][col] 行主序 |
步长等于 Bank 数 | Padding:数组宽度 +1 |
| 转置 | 读列写行 | Padding 或 Swizzle |
| 大 stride 访问 | 多个线程撞同一 Bank | 改变数据布局 |
码 3-5 · Bank Conflict 的地址算术(可实跑验证)
# 行主序 [row][col] 的地址 = row * width + col;Shared Memory 有 32 个 Bank
for width in (32, 33):
    # 一个 warp 的 32 个线程同时访问第 3 列(row = 0..31)
    banks = [(row * width + 3) % 32 for row in range(32)]
    print(width, "冲突路数 =", max(banks.count(b) for b in banks))

# 输出:
# 32 冲突路数 = 32    ← 步长 32,32 个线程全撞同一个 Bank,硬件串行化 32 次
# 33 冲突路数 = 1     ← padding 1 后步长 33,33 mod 32 = 1,依次错开,无冲突
输出是实跑结果。这就是「Padding +1」的全部原理:让访问步长
stride mod 32 ≠ 0。注意冲突是「同一 Bank 的不同地址」——若 32 个线程访问的是同一 Bank 的同一地址,硬件会广播,不算冲突。
追问:为什么 Padding 能解决冲突?
假设 32×32 的矩阵按行主序存,列访问时同一列的元素地址间隔 32,恰好都落在同一 Bank。把每行宽度改成 33(padding 1),列元素地址间隔变成 33,模 32 后依次错开,就分散到不同 Bank 了。