0.6 最重要的一个区分:Prefill 计算密集 vs Decode 访存密集
一条请求的时间、字节与状态账本
这是整本手册里最值钱的一条认知,几乎所有系统层设计都由它推导出来。
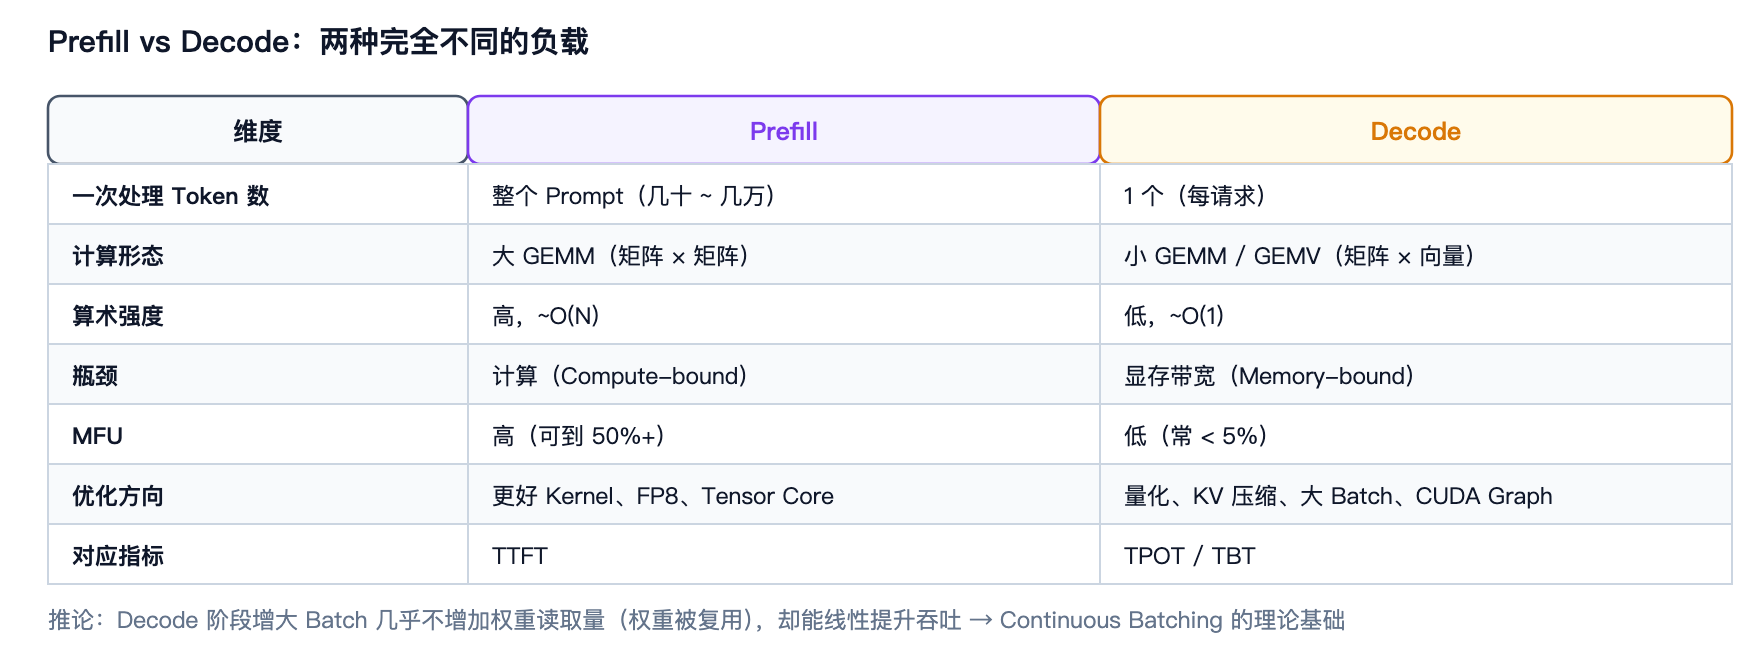 图 0-3 · Prefill 与 Decode 在计算形态、瓶颈、优化方向上的全面对比
| 维度 | Prefill | Decode |
|---|---|---|
| 一次处理多少 Token | 整个 Prompt(几十 ~ 几万) | 1 个(每请求) |
| 计算形态 | 大 GEMM,矩阵乘矩阵 | 小 GEMM / GEMV,矩阵乘向量 |
| 算术强度 | 高(~O(N)) | 低(~O(1)) |
| 常见瓶颈(需实测) | 大 GEMM 常受计算限制 | 低 batch 常受显存带宽或 Launch / 调度限制 |
| MFU | 通常较易利用矩阵算力,依 shape / 后端而变 | 低 batch 时往往较低,大 batch 可改变瓶颈 |
| 优化方向 | 更好的 Kernel、FP8、Tensor Core | 量化、KV 压缩、Batch 增大、CUDA Graph |
| 延迟指标 | TTFT | TPOT / TBT |
术语解释:
- Prefill(预填充阶段):把用户输入的全部 Prompt Token 一次性并行前向,建立 KV Cache 的阶段。
- Decode(解码阶段):自回归逐 Token 生成的阶段,每步只处理一个新 Token 并复用历史 KV Cache。
- GEMV(General Matrix-Vector multiply,通用矩阵向量乘):
y = A × x,其中x是向量,是 Decode 阶段的主要算子形态,访存受限。 - 算术强度(Arithmetic Intensity):每读写 1 字节数据所对应的浮点运算次数(FLOPs / Bytes),是判断「计算受限」还是「访存受限」的核心指标。
- Compute-bound / Memory-bound(计算受限 / 访存受限):前者受限于算力峰值,加带宽没用;后者受限于带宽,加算力没用。
- Tensor Core(张量核心):GPU 内专做矩阵乘累加的硬件单元,支持 FP16/BF16/TF32/FP8/INT8 混合精度,吞吐远高于普通 CUDA Core。
追问:为什么 Decode 是访存密集? 生成一个 Token 需要把全部模型权重从 HBM 读一遍(MoE 只读激活专家),而计算量只有 2×参数量 FLOPs。以 70B 模型 FP16 为例:读 140 GB 权重,算 140 GFLOPs,算术强度 ≈ 1 FLOP/Byte,远低于 GPU 的机器平衡点(H100 约 300+)。所以带宽是天花板,加算力没用。
推论:Decode 阶段增大 Batch 几乎不增加权重读取量(权重被复用),却能线性提升吞吐 → 这就是 Continuous Batching 的理论基础。