5.4 FlashAttention(1/2/3 演进)
GQA/MLA、在线 Softmax 与 FlashAttention
速查:FlashAttention 是 IO-aware(访存感知) 的 Attention 实现,把 Q/K/V 分块搬进 SRAM,用 online softmax 增量计算,不物化完整的 N×N Attention 矩阵,把显存从 O(N²) 降到 O(N),速度提升数倍。
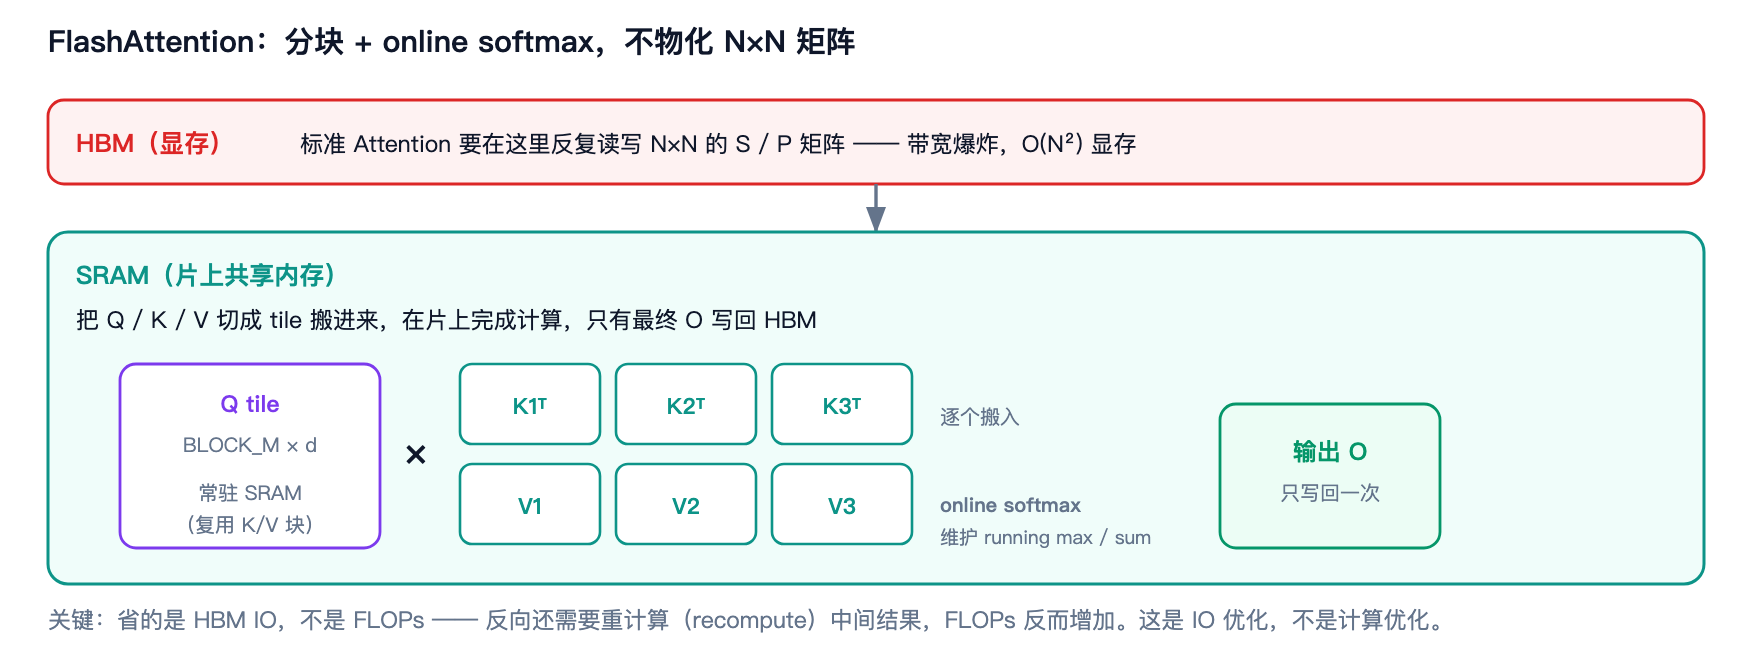 图 3-1 · 把 Q/K/V 分块搬进片上 SRAM 计算,只有最终输出写回 HBM
术语解释:
- IO(Input/Output):此处特指 GPU 与显存之间的数据读写;IO-aware 指算法设计时把访存开销作为第一约束。
- HBM(High Bandwidth Memory,高带宽显存):GPU 的主显存,容量大(GB 级)但相对片上存储慢很多。
- SRAM(Static Random Access Memory,静态随机存储器):此处指 GPU 的片上共享内存 / L1,容量小(约 100 KB / SM)但带宽极高。
- Tile / Tiling(分块):把大矩阵切成小块逐个处理,让数据在片上复用。
- Online Softmax(在线 Softmax):分块计算 softmax 的技术,通过维护 running max 和 running sum,逐块增量更新结果,与一次性 softmax 数学等价。
- 重计算(Recomputation):反向传播时不保存中间结果,而是重新算一遍,用计算换显存。
- 物化(Materialize):把中间结果实际写进显存(与之相对的是「留在寄存器/片上」)。
标准 Attention:
  S = QKᵀ        → 写入 HBM(N×N,巨大)
  P = softmax(S) → 读 HBM 再写 HBM
  O = PV         → 读 HBM
  问题:N×N 矩阵反复读写 HBM,带宽爆炸

FlashAttention:
  把 Q/K/V 切成 tile,逐个搬进 SRAM
  在 SRAM 内做 QKᵀ → online softmax → PV
  只有最终 O 写回 HBM
  代价:反向时需要重算(recompute)而不是存中间结果
码 3-1 · online softmax 的参考实现(FlashAttention 的核心)
import math
import torch

def flash_attention_ref(q, k, v, block_n=128):
    """非 causal、float32 参考实现;单个 score tile 仍会物化。"""
    q, k, v = q.float(), k.float(), v.float()
    out = torch.zeros((q.shape[0], v.shape[-1]), device=q.device)
    m = torch.full((q.shape[0],), -float("inf"), device=q.device)
    l = torch.zeros(q.shape[0], device=q.device)
    for j in range(0, k.shape[0], block_n):
        k_blk, v_blk = k[j:j + block_n], v[j:j + block_n]
        s = q @ k_blk.T / math.sqrt(q.shape[-1])   # 只算当前块的分数,不写 HBM
        m_new = torch.maximum(m, s.max(dim=-1).values)
        p = torch.exp(s - m_new[:, None])          # 用新 max 重标定本块
        alpha = torch.exp(m - m_new)               # 旧累加项的修正因子
        l = l * alpha + p.sum(dim=-1)
        out = out * alpha[:, None] + p @ v_blk     # 旧结果先缩放,再并入新块
        m = m_new
    return out / l[:, None]
整段代码的精髓就是四行:m_new(新的 running max)、alpha(旧结果的修正因子)、out = out * alpha + p @ v_blk(缩放后合并)、m = m_new。
- 为什么必须有
alpha:分块后当前块的最大值可能大于此前所有块的最大值,一旦m变大,之前用旧m算出的exp(s - m)全部偏大,必须整体乘exp(m_old - m_new)修正。alpha把「重标定」从「重算整块」降成「一次缩放」——这就是 online 的含义。 - 数值校验方法:用同一组 Q/K/V 比较本参考实现与
torch.softmax(Q @ K.T / sqrt(D), dim=-1) @ V,分别测多个序列长度和 block 大小;float32 下用合适的atol/rtol,记录实际最大误差,不把数学等价误当逐 bit 相同。
三代演进:
| 版本 | 关键改进 | 收益 |
|---|---|---|
| FA1(2022) | Tiling + online softmax + 重计算,不物化 S/P | 显存 O(N²)→O(N),速度 2–4× |
| FA2(2023) | 更好的工作划分(按序列维并行)、减少非矩阵乘 FLOPs | 比 FA1 约 2×,并行度更高 |
| FA3(2024) | Hopper 专属:TMA(Tensor Memory Accelerator,张量内存加速器)、WGMMA(Warpgroup Matrix Multiply-Accumulate,线程组级矩阵乘指令)、FP8、ping-pong 调度 | H100 上比 FA2 再快 1.5–2× |
追问:FlashAttention 会减少 FLOPs 吗?
不会,甚至因为重计算在反向时增加 FLOPs。它省的是显存 IO,把 Attention 从「访存受限」推向「计算受限」。所以它是 IO 优化,不是计算优化——这个区分面试官很爱考。
追问:为什么 online softmax 是关键?
因为要分块算 softmax,就必须解决「当前块的最大值可能不是全局最大值」的问题。online softmax 维护 running max 和 running sum,每处理一个新块就按新 max 重标定之前累加的结果,从而保证与一次性 softmax 数学等价。