8.5 Attention Backend、CUDA Graph 与 torch.compile
分页、连续批处理、前缀缓存、图与编译
Attention Backend 与图模式的兼容矩阵
PagedAttention 描述分页 KV 的寻址 / 管理思想,FlashAttention 描述 Attention 的 IO tiling;框架中的 Backend 还要对接 dtype、mask、布局、混合批次与硬件。它们可以组合,不是互斥的算法名单。
| 检查维度 | 需要确认的事实 |
|---|---|
| 模型 | MHA / GQA / MLA、滑窗、head_dim 与位置编码 |
| 缓存 | KV dtype、scale 粒度、分页 block 布局、Prefix 共享 |
| 请求 | Prefill / Decode 混批、投机验证、长序列、动态 token 数 |
| 图优化 | 哪段 compile、哪段捕获 Graph、Attention 是否是 graph break |
| 硬件 | GPU 架构、CUDA / 驱动、所选 backend 的支持条件 |
先让后端自动选择并保存日志;只有明确支持且有对照实验时才强制指定。--enforce-eager 可作为关闭图路径的诊断对照,但其精确行为按版本检查;Eager 更容易观察错误,也可能降低性能。Piecewise Graph 切分和 full Graph 捕获由动态操作、后端能力与模型决定,不能把“启用了 compile”当成所有算子都融合。vLLM Quickstart:Attention 后端
对照实验:相同模型和 workload 下测自动后端 / 受支持后端、Eager / Graph;报告首次编译捕获、稳态延迟、Graph 额外显存和 padding token 数。更低的 launch 成本可能被额外 padding 算术抵消。
Stream、Event、Graph 的先后关系
H2D stream:  拷贝 batch metadata ─ record(event)
compute:                       wait(event) ─ model kernels ─ record(done)
CPU:       准备下一批                          回收已完成请求
copy_stream = torch.cuda.Stream()
ready = torch.cuda.Event()
with torch.cuda.stream(copy_stream):
    gpu_input.copy_(cpu_input, non_blocking=True)  # cpu_input 应为 pinned memory
    ready.record()
torch.cuda.current_stream().wait_event(ready)
out = model(gpu_input)
不同 stream 没有天然顺序;异步拷贝源内存过早释放或复用会造成偶发错误。CUDA Graph 将稳定的 Kernel 提交序列捕获后重放,适合 Shape/地址可固定的 Decode 桶;动态分配、CPU 数据依赖与 Batch 变化需通过 padding/bucketing 或 fallback 处理。Profiler 中如果每个小 Kernel 前都有 CPU 空隙,先看 launch 和 Graph;若 GPU Kernel 本身长,Graph 通常不是第一优先级。
CUDA Graph
速查:CUDA Graph 把一系列 Kernel 预先 Capture(捕获) 成一张执行图,之后通过 Replay(重放) 一次性提交,降低 CPU 调度、Driver 调用和 Kernel Launch 开销。它优化的是执行调度开销,不是 Attention 的数学计算本身。
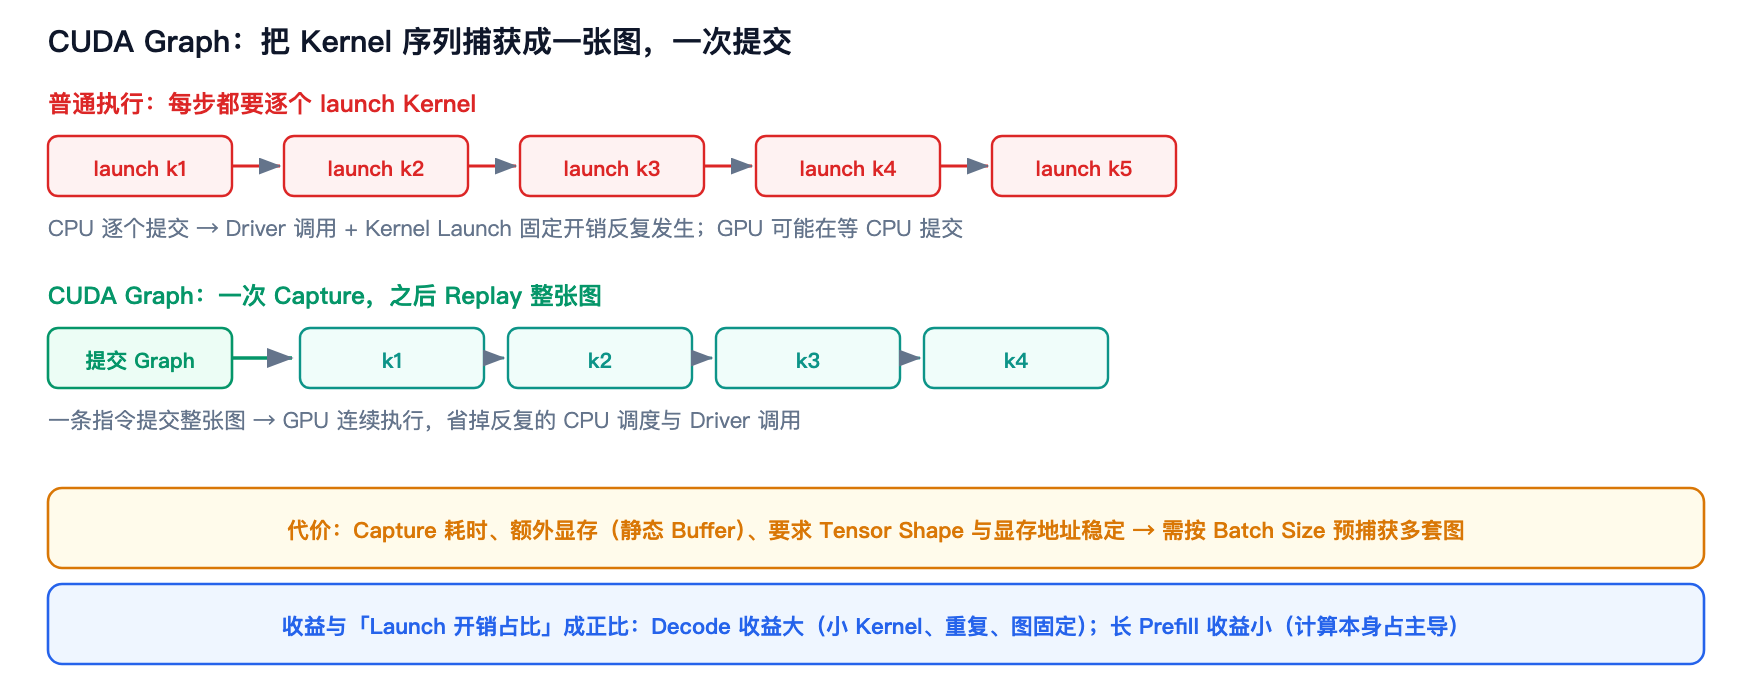 图 4-1 · 普通执行逐个 launch Kernel;CUDA Graph 一次提交整张图
术语解释: 码 4-1 · CUDA Graph 的捕获与重放
g = torch.cuda.CUDAGraph()

# ① 预热:捕获前相关算子必须已在真实 stream 上跑过,否则会把初始化逻辑录进图里
static_in = torch.randn(batch, hidden, device="cuda")
for _ in range(3):
    model(static_in)

# ② 捕获:把整条 kernel 序列及其依赖关系录成一张图
with torch.cuda.graph(g):
    static_out = model(static_in)

# ③ 重放:数据必须写进同一块 static_in —— 不能换张量、不能换地址
static_in.copy_(next_batch)      # 正确:原地写入
g.replay()
out = static_out.clone()

# static_in = next_batch         # 错误:静默失效——图里绑定的仍是旧地址
两块固定地址的
static_in/static_out就是「静态形状 + 静态地址」约束的来源,也是 Graph 额外占显存的原因。第 ③ 步是实践中最容易踩的坑:copy_是原地写,=是重新绑定变量名,后者不会报错但结果全错。
- CUDA Graph(CUDA 执行图):把一串 Kernel 及其依赖关系记录成有向图,之后可整体重放。
- Capture / Replay(捕获 / 重放):Capture 是把 Kernel 序列录制成图的过程;Replay 是按图一次性提交执行。
- Kernel Launch Overhead(核函数启动开销):每次启动 Kernel 时 CPU 构造参数、调用驱动、提交到 GPU 的固定成本,Kernel 越短这个开销占比越高。
- Driver(驱动):操作系统与 GPU 之间的中间层,CUDA 调用最终都要经过它。
- 静态 Buffer(静态缓冲区):预先分配、地址固定的输入/输出显存,Graph 重放要求地址稳定。
普通 CUDA 执行(每步都要):
  CPU: launch k1 → launch k2 → ... → launch kn
       ↑ 每次 launch 都有 CPU→Driver→GPU 的固定开销
  GPU: 执行 k1 → 执行 k2 → ... (CPU 可能还没提交完,GPU 在等)

CUDA Graph:
  一次性 Capture 整条 Kernel 序列 → 生成 Graph
  Replay 时一条指令提交整张图 → GPU 连续执行
收益:
- 主要省 CPU Kernel Launch Overhead,对「大量小 Kernel、重复执行、计算图固定」的场景收益最大。
- 最适合 LLM Decode:每步计算图重复、Batch 较小、单 Kernel 短,容易受 Launch 开销影响,能显著降低 TPOT。
代价:
- 初始化 Capture 耗时;
- Graph 占用额外显存(静态输入/输出 Buffer);
- 要求 Tensor Shape 和显存地址尽量稳定 → 框架需预分配静态 Buffer,并按不同 Batch Size 提前 Capture 多套 Graph。
追问:为什么长 Prompt Prefill 用 CUDA Graph 收益不明显?
因为 Prefill 计算量大,计算本身占主要时间,Kernel Launch 占比很低,属于「计算受限」;CUDA Graph 省的那点 Launch 开销被淹没在计算时间里。收益与「Launch 开销占比」成正比。
追问:CUDA Graph 和动态 Kernel 选择为什么不兼容?
Graph 在 Capture 时就固定了 Kernel 序列,Replay 时无法更换。如果框架想根据 Context(上下文,此处指历史序列长度) 长度动态选 Kernel(如两种 Paged Attention 实现),Graph 里就只能捕获其中一种。解决思路是做
(batch, context_bucket)的图池,但显存和捕获成本会上升。
torch.compile
速查:torch.compile 是 PyTorch 2.0 的编译器,通过 TorchDynamo → FX Graph → AOTAutograd → TorchInductor 把模型编译成融合的 Triton/CUDA Kernel,实现算子融合、图优化和减少 Python 开销。
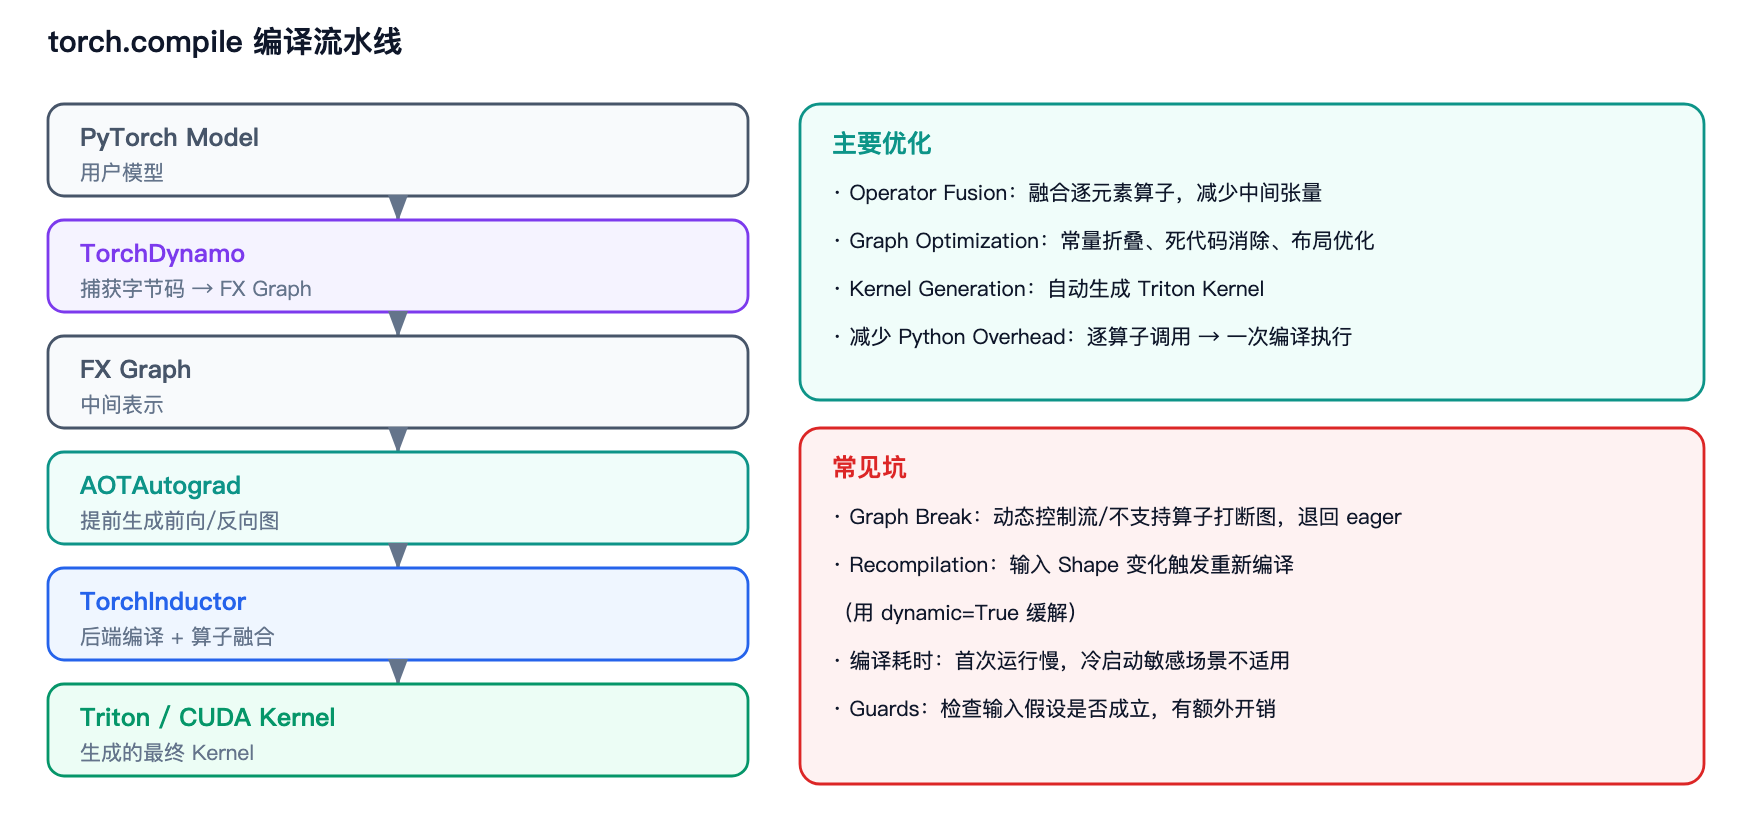 图 4-2 · 编译流水线的四个阶段,以及主要优化与常见坑
术语解释:
- torch.compile:PyTorch 2.0 引入的即时编译器(JIT Compiler)接口,一行代码即可编译模型。
- TorchDynamo:捕获 Python 字节码并生成计算图的组件;遇到不支持的算子会 Graph Break(图中断),退回逐算子 eager 执行。
- FX Graph(Functional eXchange Graph):PyTorch 的图中间表示(IR),由节点和边组成的计算图。
- AOTAutograd(Ahead-Of-Time Autograd,提前自动微分):提前生成前向/反向计算图并做图级优化。
- TorchInductor:后端编译器,负责算子融合与代码生成(默认生成 Triton Kernel)。
- Recompilation(重编译):输入 Shape 变化导致需要重新编译,带来额外开销。
- Guard(守卫):运行时检查输入假设(如 Shape、dtype)是否仍然成立,不成立则重编译。
PyTorch Model
    ↓
TorchDynamo        # 捕获 Python 字节码,生成 FX Graph
    ↓
FX Graph
    ↓
AOTAutograd        # 提前生成前向/反向图,做图级优化
    ↓
TorchInductor      # 后端编译器,做算子融合 + 生成代码
    ↓
Triton / CUDA Kernel
主要优化:
- Operator Fusion:融合逐元素算子、减少中间张量;
- Graph Optimization:常量折叠、死代码消除、布局优化;
- Kernel Generation:自动生成 Triton Kernel;
- 减少 Python Overhead:把 Python 逐算子调用变成一次编译后的执行。
码 4-2 · torch.compile 的用法与 Graph Break 诱因
# mode: "default" | "reduce-overhead"(含 CUDA Graph) | "max-autotune"(自动调 Triton 参数)
model = torch.compile(model, mode="max-autotune", dynamic=False)

# 反例:会触发 Graph Break —— Python 控制流依赖张量值
if x.sum() > 0:                      # 张量参与 Python 分支 → 图被切断
    x = x * 2

# 正例:改成张量运算,可以留在图内
x = torch.where(x.sum() > 0, x * 2, x)
dynamic=False意味着输入 shape 一变就重编译。推理服务里 batch 大小和序列长度天然波动,所以只有两条路:开dynamic=True(编译期变长、运行期略慢),或按 shape 桶预编译——后者与 CUDA Graph 按 batch size 桶捕获是同一个思路。
追问:torch.compile 的坑?
① Graph Break——动态控制流、不支持的算子会打断图;② Recompilation——输入 Shape 变化会触发重新编译(动态 Shape 用
dynamic=True缓解);③ 编译耗时——首次运行慢,不适合冷启动敏感场景;④ Guards——需要检查输入假设是否成立,有额外开销。
异步 Pipeline / Overlap
速查:让 CPU 调度、GPU 计算、数据传输并行执行,用「重叠(Overlap)」隐藏等待时间。
术语解释:
- Pipeline(流水线):把任务拆成多个阶段,让不同阶段并行处理不同数据。
- Overlap(重叠):让计算与通信/传输同时进行,从而隐藏其中一方的时间。
- Pinned Memory(锁页内存):被锁定在物理内存中的主机内存,支持直接 DMA 与异步拷贝。
- DMA(Direct Memory Access,直接内存访问):不经过 CPU 的数据搬运方式。
- H2D(Host to Device,主机到设备):从 CPU 内存到 GPU 显存的拷贝。
- CUDA Stream(流):GPU 上的任务队列,不同 Stream 之间的操作可以并发。
| 重叠对 | 做法 | 收益 |
|---|---|---|
| CPU 调度 ↔ GPU 计算 | CPU 提前准备下一个 Batch 的元数据,GPU 同时 Decode 当前 Batch | 隐藏 CPU 开销 |
| 计算 ↔ H2D 拷贝 | 用 pinned memory + 异步拷贝 | 隐藏传输延迟 |
| 计算 ↔ 通信(多卡) | 计算与 All-Reduce / All-to-All 重叠 | 隐藏通信开销 |
| Prefill ↔ Decode | 同一 Batch 混合调度 | 提升利用率、平滑 TBT |
追问:为什么要用 pinned memory?
普通内存(pageable)的 DMA 拷贝需要驱动先锁页,是同步的;pinned(page-locked)内存可以直接 DMA,支持异步拷贝,配合 CUDA Stream 就能和计算重叠。